「赤い箱を右の棚へ置いて」と人が頼む。ロボットはカメラで赤い箱と棚を見つけ、周囲の障害物を避け、箱が滑らない強さでつかみ、目的の位置へ置く。同じ棚に初めて見る箱があっても、言葉の意味と見た目から対応する。
このように、見る、指示を理解する、身体を動かすという三つを一つにつなぐAIがVLA(Vision-Language-Action)モデルである。大規模言語モデルが文章を生成し、VLMが画像と言葉を理解するのに対し、VLAは最終的にロボットの行動を出力する。
2023年のGoogle DeepMind「RT-2」、2024年のOpenVLAとPhysical Intelligence「π0」、2025年のGemini Robotics、2026年のGemini Robotics 2やNVIDIA Isaac GR00T N1.6へと、VLAは急速に発展した。複数のロボットから学び、未知の物体や自然言語の指示へ対応し、全身を制御する方向へ進んでいる。
一方、文章の間違いなら修正できても、ロボットの誤動作は物や人を傷つける。成功率、遅延、学習データ、機体差、長い工程、非常停止など、現実世界特有の課題は大きい。「VLAを導入すればプログラミングが不要になる」という理解も正確ではない。
本稿では、VLAモデルとは何か、映像と言語がどのように動作へ変わるのか、VLM・ワールドモデル・従来制御との違い、主要モデル、学習データ、企業での使い方、安全性、今後の展望までを2026年9月時点の情報で整理する。
この記事の要点
- VLAモデルは、カメラ映像と自然言語を入力し、ロボットの行動を出力する基盤モデルである
- ウェブ規模の視覚・言語知識と、実機の行動データを組み合わせることで、未知の指示や物体への汎化を狙う
- 行動をトークン、連続値、動作チャンクなどで表し、閉ループで観測と行動を繰り返す
- VLMは主に理解と推論、ワールドモデルは未来予測、VLAは実際の行動生成に重点がある
- RT-2、OpenVLA、π0系、Gemini Robotics、GR00Tなどは公開範囲、機体、速度、学習方法が異なる
- 実装には安全制御、現場データ、低遅延計算、実機評価、人の介入が必要で、VLA単体では完結しない
VLAモデルとは何か
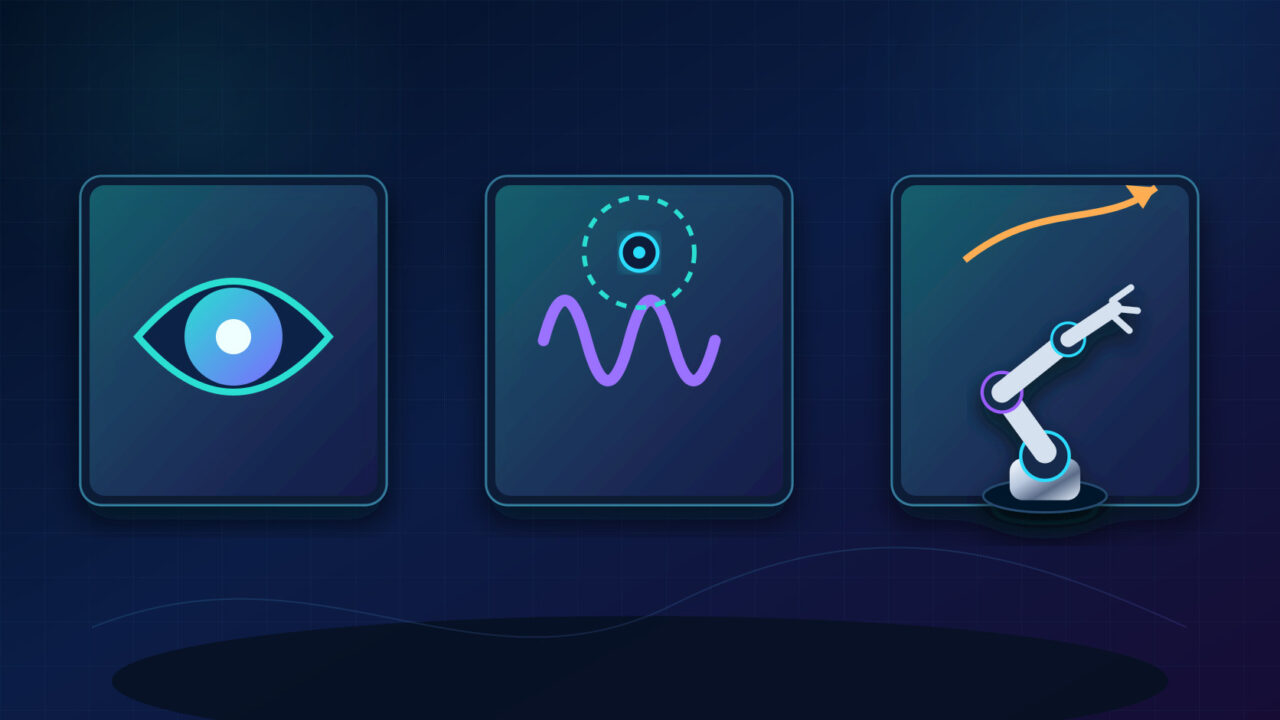
VLAはVision-Language-Actionの略で、日本語では「視覚・言語・行動モデル」などと表現される。ロボットのカメラ画像や動画、自然言語の指示、現在の機体状態を受け取り、次に実行する動作を生成する。
典型的な入力と出力は次のようになる。
- Vision:RGB画像、動画、深度、複数カメラの映像
- Language:「机を片付けて」「青いカップを取って」といった指示
- Robot state:関節角度、手先位置、グリッパー状態、速度
- Action:手先の移動、関節の目標値、グリッパー開閉、移動方向
従来の産業用ロボットは、人が位置、速度、順序、条件分岐を細かく記述することが多かった。環境を整えれば高い精度と速度を出せる一方、箱の位置や種類が変わると、プログラムと設備を調整する必要がある。
VLAは大量データから物体、言葉、動作の関係を学ぶ。「赤」「箱」「棚」という意味をウェブの画像・言語知識から利用し、実機データで「つかむ」「運ぶ」「置く」に必要な動作を学ぶ。完全に初めての指示でも、既知の概念を組み合わせて対応できる範囲を広げることが目的だ。
VLMやLLMとは何が違うのか
大規模言語モデル(LLM)は、文章を読み、次の言葉を生成する。視覚言語モデル(VLM)は、画像や動画と言葉を対応付け、物体の説明、質問応答、空間理解を行う。VLAは、VLMの理解をロボットの動作へ接続する。
| モデル | 主な入力 | 主な出力 | 代表的な用途 |
|---|---|---|---|
| LLM | テキスト | テキスト、コード | 対話、検索、文書作成 |
| VLM | 画像・動画・テキスト | 説明、回答、位置、推論 | 画像理解、検査、空間認識 |
| VLA | 視覚・言語・機体状態 | ロボット行動 | 把持、移動、組み立て、片付け |
| ワールドモデル | 観測・行動 | 次の状態、未来映像、評価 | 予測、計画、シミュレーション |
境界は明確に分かれているわけではない。VLAが動く前に理由を出し、未来を予測することもある。ワールドモデルが行動を直接生成する場合もある。それでも、何を最終出力として最適化しているかを見ると理解しやすい。
視覚と言語はどう行動へ変わるのか
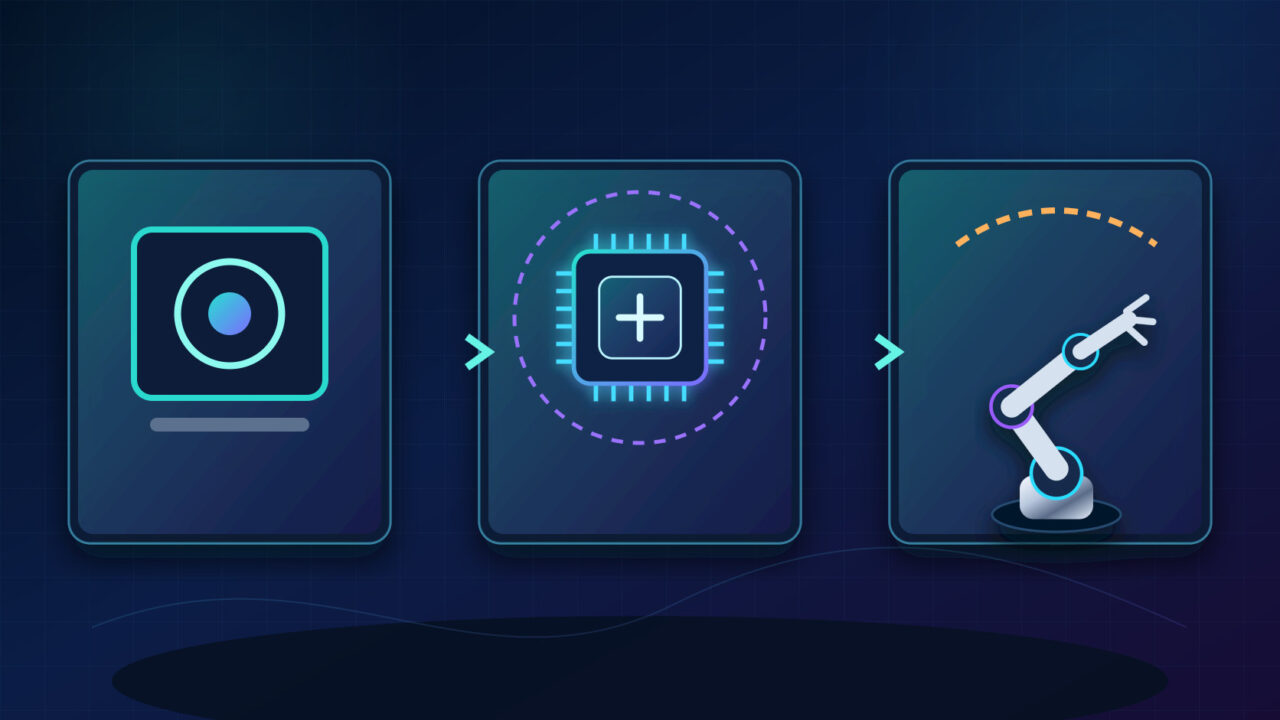
VLAの構造はモデルごとに異なるが、大きく四つの処理に分けられる。
1. 映像を特徴へ変換する
カメラ画像を視覚エンコーダーへ入れ、物体、形、色、位置関係を表す数値へ変換する。画素をそのまま使うのではなく、行動に必要な情報を圧縮する。
2. 指示と状況を統合する
言語モデルまたはVLMが、「どの物を」「どこへ」「どの条件で」動かすかを理解する。同じ映像でも、「赤い箱を取る」と「赤い箱を避ける」では必要な行動が変わる。
3. 行動を生成する
モデルは、手先の位置変化、回転、グリッパーの開閉などを生成する。離散的なトークンとして出す方式と、連続値を直接生成する方式がある。
4. 再観測して修正する
ロボットが少し動いたら、再びカメラと機体状態を入力する。物が滑った、人が入った、対象を見失った場合に次の行動を変える。この閉ループ制御が、事前に全動作を一度で作る方式との大きな違いだ。
行動トークンと動作チャンク
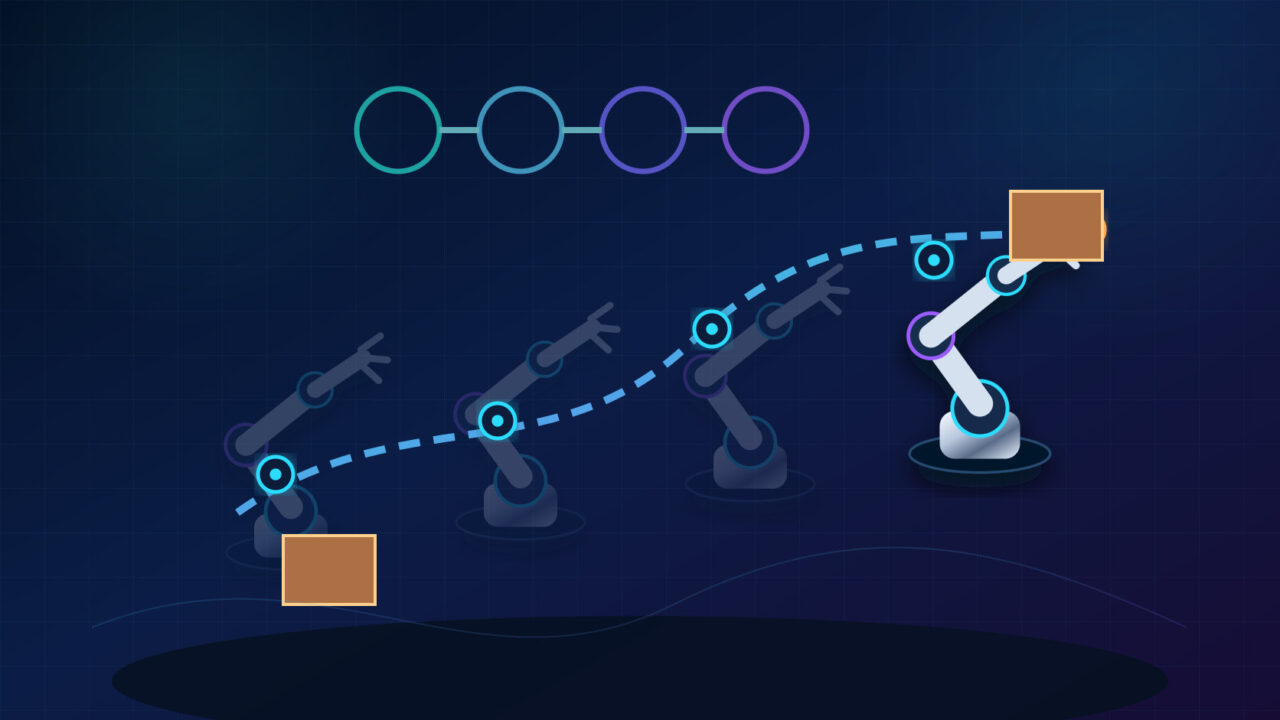
言語モデルは単語や文字をトークンとして扱う。初期のVLAには、ロボットの連続的な動作を数値区間に分け、行動トークンとして扱うものがある。RT-2はロボットの動作をテキストトークンのように表し、ウェブ知識と行動学習を同じ枠組みへ入れた。
ただし、ロボットは毎秒何十回も制御する。動作を一つずつ大きなモデルから受け取ると、遅延と揺れが問題になる。そこで、数ステップ分をまとめた「アクションチャンク」を一度に生成する方法が使われる。
アクションチャンクには、滑らかさと計算効率の利点がある。一方、長いチャンクを作るほど、途中で環境が変わったときの修正が遅れる。短くすれば反応性は上がるが、推論回数と計算負荷が増える。
Physical Intelligenceのπ0は、Flow Matchingを使って連続的な動作チャンクを生成する。OpenVLAは動作を離散トークンとして扱う。優劣が一つに決まるのではなく、機体、制御周期、タスク、計算資源で選択が変わる。
VLAはどのように学習するのか
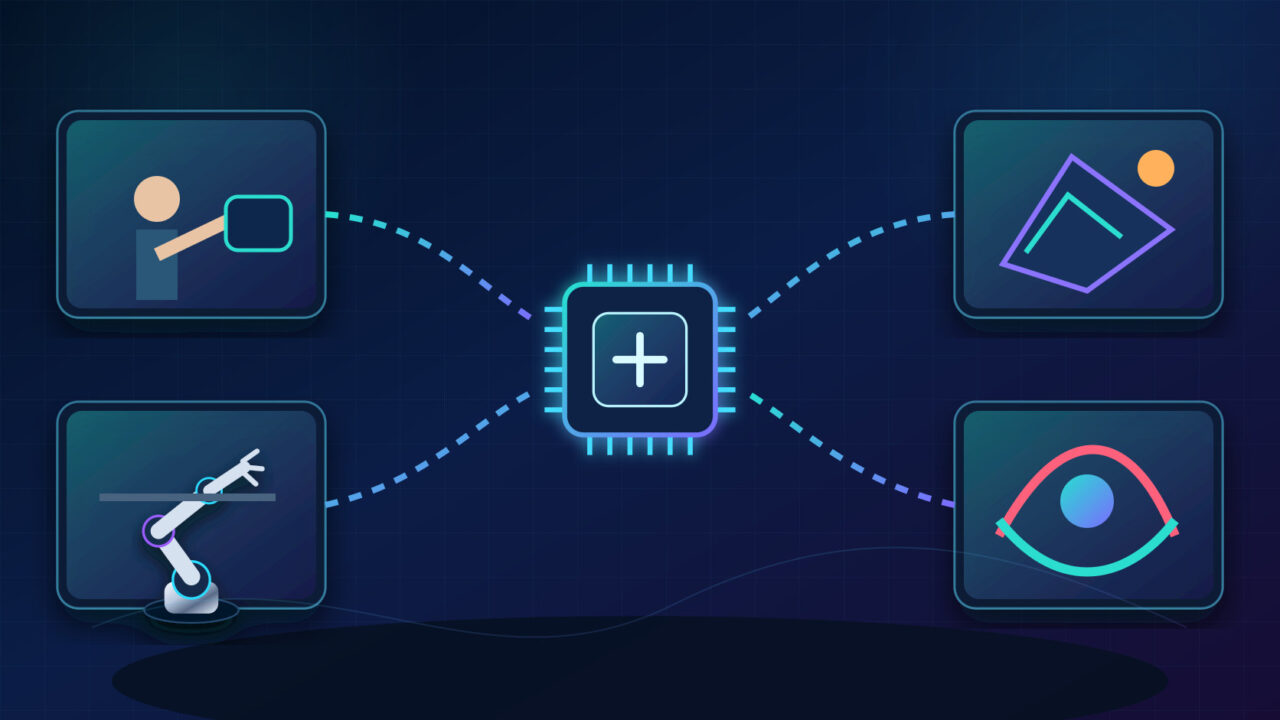
VLAの学習には、映像と指示だけでなく、実際に行った動作が必要だ。一般的な一件のデータには、複数カメラ映像、自然言語のタスク、関節状態、行動、成功・失敗、時刻が含まれる。
主な収集方法は次の通りである。
遠隔操作
人がコントローラーやVR装置でロボットを動かし、映像と動作を記録する。高品質な実演を集めやすいが、人員と時間が必要になる。
手取り教示
人がロボットアームを直接動かし、軌道を記録する。直感的だが、大型機体や移動ロボットでは難しい。
自律実行と人の修正
モデルに作業させ、失敗しそうなときだけ人が介入する。弱点に近いデータを効率よく集められるが、安全な収集環境が必要だ。
シミュレーションと合成データ
仮想環境で物体、照明、配置、失敗条件を変えて経験を増やす。現実との差を小さくするため、実データによる調整が必要になる。
複数機体の共有データ
Open X-Embodimentのように、異なる研究機関とロボットのデータを共通形式へ集める。多様性は高まるが、カメラ、座標系、動作表現、品質の違いを吸収しなければならない。
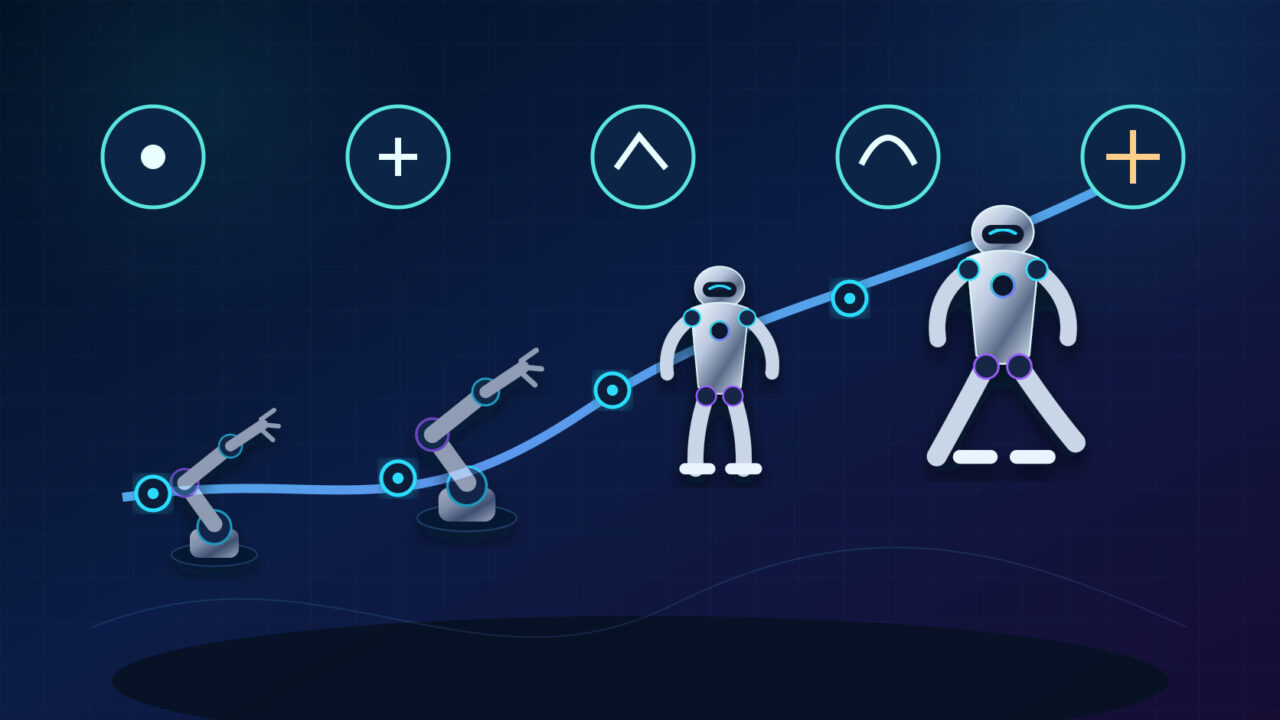
VLAの進化——RT-2から2026年まで
RT-2:ウェブ知識をロボットへ移す
Google DeepMindが2023年に発表したRT-2は、Vision-Language-Actionという呼び方を広く定着させた。画像と言語で事前学習したVLMを、ロボットの行動データと共同で学習し、行動をトークンとして出力した。
重要だったのは、ロボット実演に直接含まれない概念をウェブ知識から利用できる可能性を示したことだ。「絶滅した動物のところへ物を移す」「落ちそうな物を選ぶ」といった、意味理解を伴う指示への対応が報告された。
OpenVLA:オープンな研究基盤
2024年のOpenVLAは、7BパラメーターのオープンソースVLAである。Open X-Embodimentの97万ロボットエピソードで事前学習され、研究者や企業が追加学習しやすい基盤を提供した。
OpenVLAの価値は、性能だけでなく、重み、学習方法、評価を検証できることにある。クラウドの非公開モデルに依存せず、機密データを自社環境で扱いたい企業にも参考になる。一方、実時間制御、計算資源、対象機体への調整は利用者が担う。
π0・π0.5・π*0.6:連続動作と経験学習
Physical Intelligenceのπ0は、複数機体のデータとVLMを組み合わせ、Flow Matchingで連続的な動作チャンクを生成した。π0.5はウェブデータ、複数ロボット、高水準の意味予測を共同学習し、未知の家庭環境での汎化を重視した。
その後のπ*0.6では、強化学習を使って実行経験から成功率と処理速度を改善する方向が示された。人の実演をまねるだけでなく、自ら試した結果から改善する流れである。
Gemini Robotics:推論と動作を統合
Google DeepMindは2025年、Gemini 2.0を土台とするGemini Roboticsを発表した。自然言語への追従、未知物体と配置への適応、器用な操作を重視し、ERモデルが空間理解と高水準の計画を担当する構成を示した。
2026年のGemini Robotics 2では、全身制御、多指操作、複数ロボット連携、数分間のタスク、オンデバイス適応まで範囲が広がった。
GR00T N1.6:オープンなヒューマノイドVLA
NVIDIA Isaac GR00T N1.6は、ヒューマノイド向けのオープンな推論VLAである。NVIDIA Cosmos Reasonを使って状況理解と推論を補い、全身制御へ対応する。シミュレーション、合成データ、Jetson、Isaacと組み合わせた開発環境が特徴だ。
主要VLAモデルの比較
| モデル | 発表 | 主な特徴 | 公開性・利用形態 |
|---|---|---|---|
| RT-2 | 2023 | VLMのウェブ知識を行動トークンへ転用 | 研究成果中心 |
| OpenVLA | 2024 | 7B、97万エピソード、追加学習可能 | オープンソース |
| π0系 | 2024〜2025 | Flow Matching、動作チャンク、複数機体 | 研究成果・一部コード等 |
| Gemini Robotics 2 | 2026 | 全身制御、器用さ、複数ロボット | 早期アクセス中心 |
| Gemini Robotics On-Device 2 | 2026 | 低遅延、ローカル、新機体への高速適応 | 早期アクセス中心 |
| NVIDIA GR00T N1.6 | 2026 | ヒューマノイド向け推論VLA、Cosmos連携 | オープンモデル |
比較では、ベンチマークの数字だけでなく、対応する観測、行動表現、機体、制御周波数、学習データ、ライセンスを見る必要がある。同じ「成功率」でも、物体、工程、評価者が違えば単純比較できない。
ワールドモデルとの違いと連携
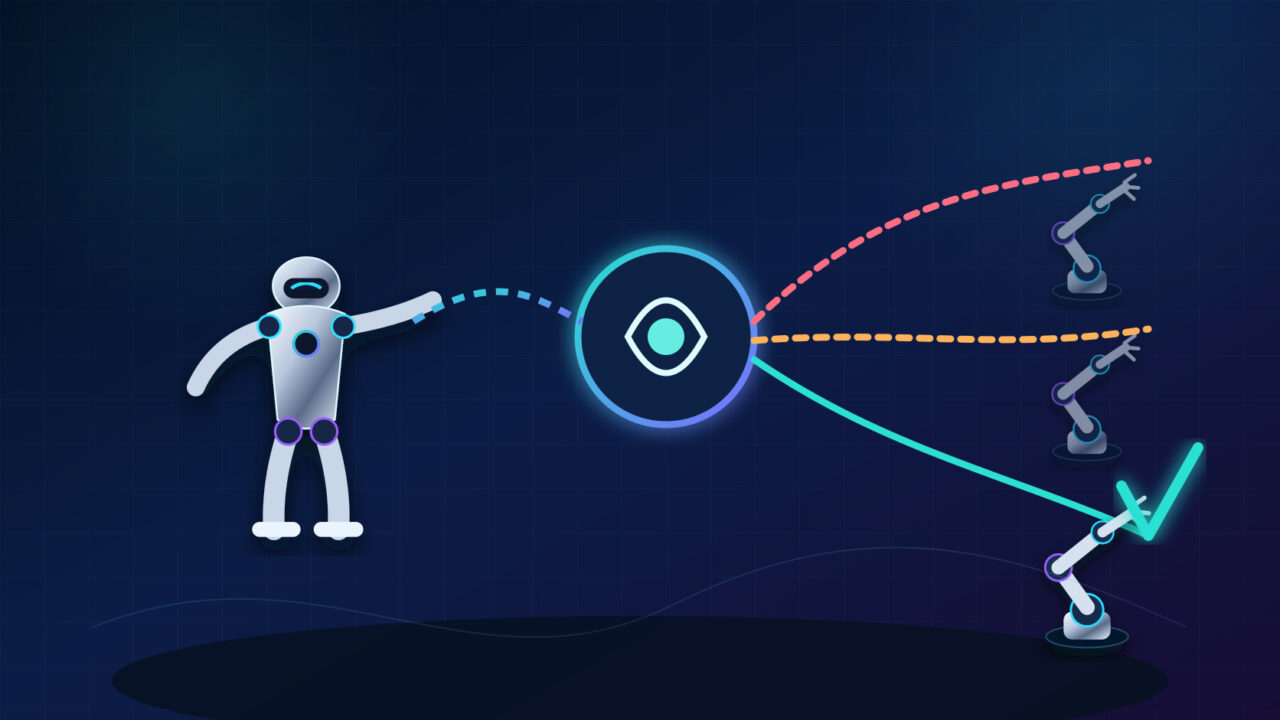
VLAは「次にどう動くか」を生成する。ワールドモデルは「その動きをしたら世界がどう変わるか」を予測する。両者を組み合わせれば、実行前に複数の行動候補を仮想的に試し、安全性や目標への近さを比較できる。
例えばロボットアームが箱を取るとき、VLAが三つの軌道を作り、ワールドモデルが衝突、滑り、到達後の状態を予測する。最も安全な軌道を少し実行し、再観測して計画を更新する。
NVIDIA Cosmos 3は、世界理解、未来生成、行動予測をフィジカルAIの基盤としてまとめる。Gemini Robotics 2やGR00TのようなVLAは、実機の動作生成を強く担う。将来は、一つのモデルが理解、予測、行動を持ち、名称の境界はさらに薄くなる可能性がある。
従来のロボット制御は不要になるのか
不要にはならない。VLAが得意なのは、曖昧な言語指示、多様な物体、環境変化への対応である。従来制御が得意なのは、高速で正確な反復、決められた軌道、安全制約、リアルタイム保証だ。
実用システムは次のような階層になる。
- タスク管理:何をいつ行うかを決める
- VLM・ER:現場を理解し、工程を計画する
- VLA:短い行動列を生成する
- モーションプランナー:衝突のない軌道へ変換する
- 低水準制御:モーターを高速に制御する
- 安全系:速度、力、区域、非常停止を独立監視する
VLAが直接モーターを動かす研究もあるが、産業用途では独立した制約と監視を挟むほうが安全で検証しやすい。AIは自由度を高め、従来制御は境界を守るという分業が現実的である。
どのような用途に向くのか
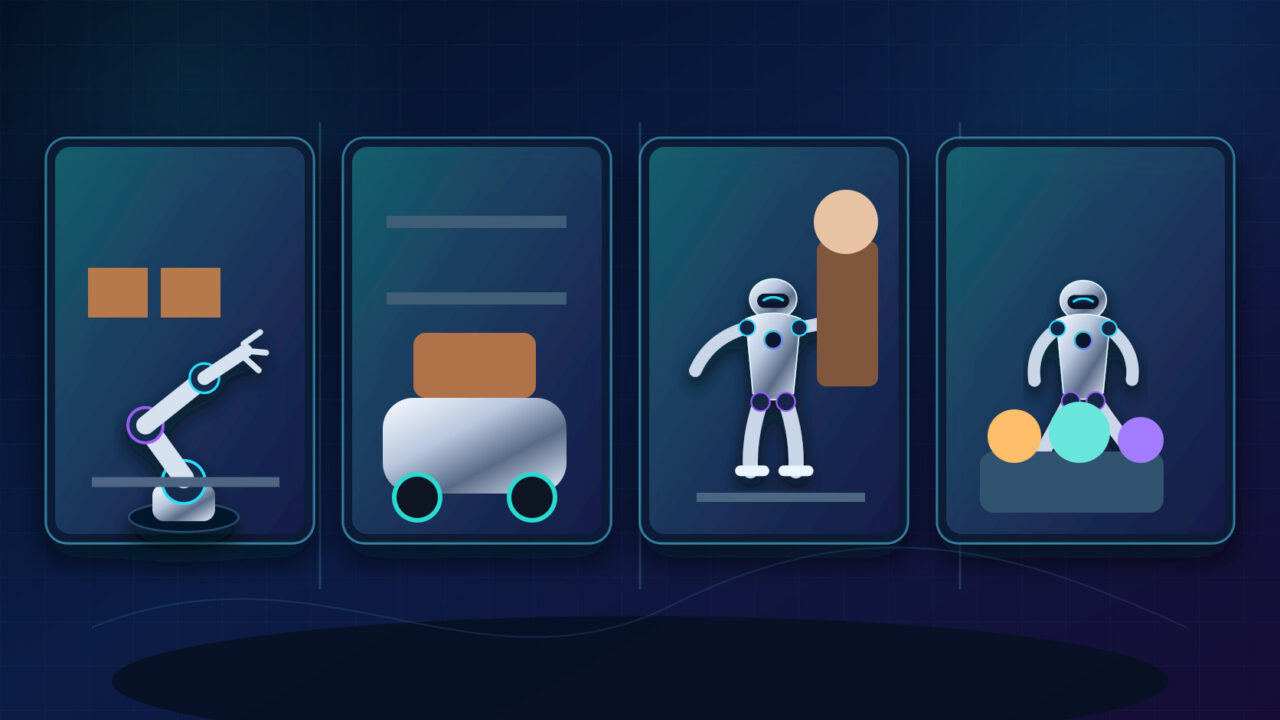
多品種のピック&プレース
商品や部品の種類と位置が変わる倉庫で、自然言語や注文情報から対象を選び、箱へ入れる。固定ルールで全商品を登録する負担を減らせる。
組み立てとキッティング
複数の道具や部品を順番に集め、作業者へ渡す。仕様変更を言語で指示し、視覚で部品を確認する使い方が考えられる。
店舗・宿泊のバックヤード
補充、清掃、リネン、食器、廃棄物の運搬など、毎回状態が変わる作業に向く。顧客エリアでは速度と距離の制限が必要になる。
家庭用ロボット
片付け、洗濯物、食器、簡単な調理補助など、物体と環境の多様性が大きい分野で期待される。ただし、価格、安全、プライバシー、故障、動作時間が普及の壁になる。詳しくは「家庭用ロボットはなぜ普及しない?」で整理している。
災害・保守点検
人が入りにくい場所で、言語指示と映像を使ってバルブ、扉、工具を操作する。未知環境では完全自律より、人の遠隔監督と組み合わせる形が安全だ。
VLAモデルを導入する流れ
1. タスクを狭く定義する
「倉庫を自動化する」では広すぎる。「指定棚の6種類の箱を取り、搬送容器へ置く」のように、開始条件、成功、失敗、速度を定義する。
2. 既存モデルと機体の適合を確認する
カメラ数、関節、グリッパー、移動方式、推論GPU、ライセンスを確認する。モデルが対応しない行動表現なら変換層が必要になる。
3. 現場データを集める
代表的な成功例だけでなく、物体のずれ、照明、遮蔽、人の侵入、滑り、失敗からの復旧を記録する。個人情報と機密情報の扱いを決める。
4. 追加学習する
汎用VLAを現場データで微調整する。少数の高品質な実演、合成データ、自律実行の失敗を組み合わせる。
5. オフラインで評価する
学習に使わなかったデータで、対象選択、言語追従、動作誤差を測る。ここで良くても、実機の接触や遅延は分からない。
6. 制限環境で実機試験する
低速、軽い物、立入制限から始める。連続試行、最悪条件、非常停止、通信断を試す。
7. 本番後もデータを戻す
失敗と人の介入を記録し、再学習と評価へ戻す。モデル更新ごとに以前の安全ケースが退行していないか確認する。
実用化を阻む課題
データが高価である
ロボットデータは映像だけではなく、行動と機体状態を同期させる必要がある。人の遠隔操作、設備、故障対応に費用がかかる。
機体差が大きい
同じ二本腕でも関節長、可動域、手、カメラが違う。学習した動作を別機体へ移すには、共通表現と追加学習が必要だ。
推論遅延がある
大きなVLAは一回の推論に時間がかかる。環境が変わる前に次の動作を出し、滑らかに補間しなければならない。オンデバイス化、量子化、チャンク生成が重要になる。
長い工程で誤差が増える
短い把持に成功しても、10分間の片付けでは対象の取り違え、落下、完了判定の誤りが積み重なる。中間目標と再計画が欠かせない。
不確実性を正しく表せない
モデルが自信ありげに危険な動作を出す可能性がある。「分からない」と停止し、人へ確認する基準を設計しなければならない。
VLA導入で見落としやすい運用コスト
VLAの費用は、モデル利用料やGPUだけでは決まらない。実機データを集める担当者、遠隔操作の設備、失敗例の整理、モデル更新後の再評価、ロボットの清掃・校正・部品交換まで含めて考える必要がある。PoCで数十回動いたとしても、毎日数百回の運用では、カメラのずれ、把持部の摩耗、商品の包装変更などが性能低下につながる。
特に重要なのがデータの履歴管理である。どの機体、ソフトウェア、モデル、学習データで判断したかを追跡できなければ、失敗の原因を特定しにくい。成功例だけを追加学習すると、まれな危険条件への対応が弱くなる可能性もある。現場で人が介入した場面、停止した理由、復旧方法を同じ形式で記録し、学習用データと監査用ログを分けて保存したい。
モデル更新にも運用コストが生じる。新しい版で平均成功率が上がっても、以前できた特定作業が苦手になる「退行」が起こり得る。本番へ直接反映せず、既存版と並行して代表タスクと最悪条件を比較し、問題があれば短時間で戻せる仕組みが必要だ。クラウド障害や通信遅延に備え、最後に検証したモデルを機体側へ保持する設計も検討したい。
費用対効果は、人件費との単純比較では測れない。人の介入回数、停止時間、不良品、設備占有、教育、保守契約、電力まで含め、一作業あたりの総費用で判断する。VLAが最も価値を出しやすいのは、対象物や手順が頻繁に変わり、固定プログラムの作り直しが大きな負担になっている工程である。逆に、高速で同じ動作を繰り返す工程では、従来の専用制御のほうが安く安定する場合が多い。
安全性とセキュリティ
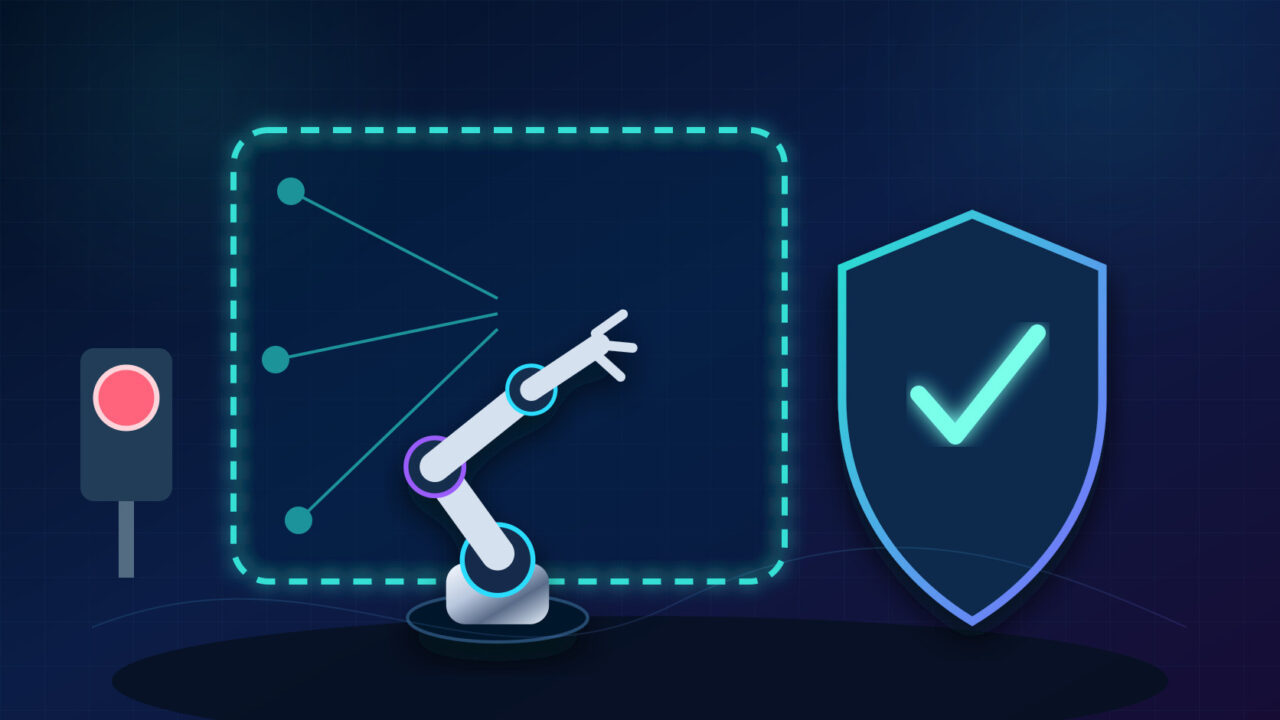
VLAは、言語入力を受ける点でも新しいリスクがある。曖昧な指示、悪意のある命令、カメラに映る文字、ネットワーク経由の不正操作が、物理的な行動につながり得る。
安全設計では、モデルへの指示と、実行を許可する制約を分ける必要がある。
- 許可された道具、区域、速度、力を明示する
- 人の接近を独立センサーで検知する
- AIから独立した安全PLCと非常停止を置く
- ネットワークと更新ファイルを認証する
- 映像、指示、行動、停止理由を記録する
- 高リスク作業は人の承認後に実行する
- 未知条件では安全側に停止する
- モデル更新前後で同じ安全試験を行う
自然言語の安全ポリシーだけでは、モーターの応答時間や制動距離を保証できない。AI安全、サイバーセキュリティ、機械安全、運用教育を別々に評価し、最後に統合する必要がある。
企業が比較するときのチェックリスト
- 対応するロボット機体とセンサーは何か
- 入力画像の枚数、解像度、履歴長はどれくらいか
- 行動の座標系、周波数、チャンク長は何か
- 推論に必要なGPUと遅延はどれくらいか
- 新タスクへ何件の実演が必要か
- オフラインやオンデバイスで動くか
- モデル重みを自社環境へ置けるか
- 商用利用と生成データのライセンスは明確か
- 失敗と不確実性を検知できるか
- 人の介入を学習データへ戻せるか
- 更新頻度と長期保守はどうなるか
- 自社の最悪条件で再現評価できるか
VLAの名称が同じでも、研究用チェックポイントと製品向けサービスでは提供範囲が異なる。APIだけで実機が動くのか、制御ソフト、シミュレーター、機体ドライバーを誰が用意するのかを確認したい。
日本企業の機会
日本は、産業用ロボット、センサー、モーター、減速機、工作機械で強い供給網を持つ。一方、VLAの競争では、大量データと基盤モデルを持つ海外企業が先行している。
勝機は、モデルの規模だけを追うことではない。食品、物流、製造、介護などの現場で、作業を安全に分解し、質の高い実演データを集め、小型モデルへ適応し、保守まで提供することにある。
特に重要なのはデータの共通化だ。カメラ、関節、手先、成功条件を各社が別形式で保存すると、モデルと機体をまたいで再利用できない。競争領域の作業データは守りながら、座標、ログ、安全イベント、評価指標を標準化する必要がある。
また、日本語の曖昧な現場指示、狭い設備、多品種少量生産、熟練者の微妙な力加減は、汎用モデルだけでは扱いにくい。現場知識をデータ化し、海外の基盤モデルと日本の機体・安全・運用を組み合わせることが差別化になる。
2026年から2030年までの展望
以下は現在の研究動向を基にしたシナリオである。
モデルは「一台専用」から「複数機体共通」へ
異なる腕、手、移動方式で共通の意味表現を使い、少量データで機体固有部分だけを適応する。動作転移が開発期間を短縮する。
実演模倣から経験学習へ
人のデータをまねるだけでなく、実機とシミュレーションで試し、成功率と速度を強化学習で改善する。安全な探索環境が重要になる。
大規模VLAと小型実行モデルが分業する
クラウドの大規模モデルが難しい計画とデータ作成を担い、ロボット上の小型モデルが低遅延で動く。教師と実行役の構成が増える。
評価は成功率から事業KPIへ
作業数、停止時間、人の介入、廃棄、電力、修理、事故に基づいて比較される。高性能なモデルより、総コストを下げるシステムが選ばれる。
VLAとワールドモデルの境界が薄くなる
行動を出す前に未来を予測し、実行後のずれを学習する。理解、予測、行動が一つの循環へ統合される。
よくある質問
VLAモデルは生成AIですか
広い意味では生成AIの一種と考えられる。文章ではなく、ロボットの行動列を生成する。VLMや拡散モデル、Flow Matchingなど、生成AIで使われる技術を組み合わせる。
ChatGPTやGeminiと何が違いますか
一般的な対話AIは主に文章や情報を出す。VLAはロボットのカメラと機体状態を受け取り、現実の動作を出す。誤りの物理的リスクが大きいため、独立した安全系が必要だ。
VLAがあればティーチングは不要ですか
完全には不要にならない。個別位置を細かく教える量は減る可能性があるが、現場データ、タスク定義、安全制限、追加学習、評価が必要になる。
オープンソースのVLAは商用利用できますか
モデルごとにライセンスが異なる。重みが公開されていても、学習データ、依存モデル、コード、商用利用、再配布の条件を個別に確認しなければならない。
家庭用パソコンで動かせますか
小型化や量子化で動くモデルもあるが、複数カメラを低遅延で処理し、実機を制御するにはGPUと周辺ソフトが必要になる。安全な実験環境も欠かせない。
すぐ人間の仕事を代替しますか
仕事全体より、対象物が限定された反復工程から導入される。例外対応、品質判断、対人業務、保守、安全管理は人の役割として残る。
まとめ——VLAは「言葉を行動へ変える」ロボットの基盤になる
VLAモデルは、視覚で現場を見て、自然言語の指示を理解し、ロボットの行動を生成する。従来は別々だった認識、意味理解、動作を一つの学習基盤へ近づけ、未知の物体、指示、配置へ対応できる範囲を広げる。
RT-2がウェブ知識を行動へ移す考え方を示し、OpenVLAがオープンな研究基盤を提供し、π0系が連続的な動作チャンクと経験学習を進めた。Gemini Robotics 2とGR00T N1.6は、全身制御、推論、複数機体、オンデバイスへ範囲を広げている。
それでも、VLAはロボットシステムの一部である。ワールドモデル、モーションプランナー、低水準制御、安全PLC、データ基盤、人の監督を組み合わせなければ、現場で安定して働けない。
導入で見るべきなのは、派手な一回の成功ではなく、未知条件で何回成功し、どう失敗し、何秒で停止し、何分で復旧できるかである。VLAが変えるのは、ロボットを「決められた動きを繰り返す機械」から「言葉と状況に応じて行動を選ぶ機械」へ近づけることだ。その価値は、自由度と安全性を同時に設計できたときに初めて生まれる。
参考資料
- Google DeepMind「RT-2: New model translates vision and language into action」
- OpenVLA公式プロジェクト
- OpenVLA論文
- Physical Intelligence「π0: A Vision-Language-Action Flow Model」
- Physical Intelligence「π0.5」
- Google DeepMind「Gemini Robotics 2」
- NVIDIA「Isaac GR00T N1.6」発表