生成AIは、文章を作り、画像を理解し、音声で会話するところまで急速に進化した。しかし、デジタル空間で正しい答えを返すことと、現実の部屋を歩き、壊れやすい物を持ち、人を避けながら仕事を終えることの間には大きな隔たりがある。
その隔たりを埋めようとしているのが、Google DeepMindが2026年7月に発表した「Gemini Robotics 2」だ。カメラ映像と自然言語の指示からロボットの動きを生成するVLA(Vision-Language-Action)を中核に、ヒューマノイドの足先から指先までを一体的に制御する。さらに、高度な計画を担当するGemini Robotics ER 2、機体上で動くGemini Robotics On-Device 2も同時に示された。
今回の更新で目立つのは、テーブル上のピック&プレースだけではない。歩く、しゃがむ、手を伸ばす、両手を使う、袋を結ぶ、複数のロボットで作業を分担するといった、現実の仕事に必要な能力へ対象が広がったことだ。
ただし、発表映像が自然に見えるからといって、すぐ家庭や工場へ万能ロボットを導入できるわけではない。タスクごとの成功率には差があり、五本指の細かな操作、速度、長時間の信頼性、安全認証、費用、機体整備には課題が残る。利用できるモデルにも公開範囲の違いがある。
本稿では、Gemini Robotics 2の三つのモデル、全身制御と器用さの仕組み、VLAとエンボディド・リーズニングの分担、産業での可能性、安全性、企業が導入前に確認すべき点までを、2026年9月時点の公式情報を基に整理する。
この記事の要点
- Gemini Robotics 2は、視覚と言語をロボットの動作へ変換するGoogle DeepMindの最新VLAモデルである
- ヒューマノイドの歩行、姿勢変更、両腕、手指を一つの流れとして制御できる範囲が広がった
- ER 2が高水準の理解・計画・進捗管理を、VLAが連続的な身体動作を担当する
- On-Device 2は機体上で動き、新しいロボットへ少量の追加データで適応することを狙う
- 複数ロボットの連携や数分間のタスクが示された一方、細かな手指操作や実環境での長期安定性は発展途上である
- AIだけに安全を任せず、速度制限、停止系、作業区域、実機試験を含む多層防御が必要になる
Gemini Robotics 2とは何か
Gemini Robotics 2は、Google DeepMindが開発するロボット向け基盤モデル群の第2世代である。単一のロボット製品名ではなく、現実世界を理解し、作業を計画し、機体を動かすための「知能の層」を指す。
Google DeepMindは2025年に初代Gemini Roboticsを発表し、Geminiのマルチモーダル理解を実世界の操作へ接続した。その後、複数のロボット機体への動作転移、長い工程の推論、ローカル実行を進め、2026年のGemini Robotics 2では全身制御、両手・多指の操作、複数ロボット連携まで範囲を拡大した。
モデル群は大きく三つに分かれる。
| モデル | 主な役割 | 主な出力 | 想定する実行場所 |
|---|---|---|---|
| Gemini Robotics 2 | 視覚と言語からロボットを直接制御するVLA | 関節・手先・歩行などの動作 | ロボット開発基盤、対応機体 |
| Gemini Robotics ER 2 | 現実世界の理解、対話、複数工程の計画と監督 | 計画、判断、ツール呼び出し、VLAへの指示 | クラウドまたは開発環境 |
| Gemini Robotics On-Device 2 | 低遅延・オフラインを重視した小型VLA | 機体上でのリアルタイム動作 | ロボット内の計算機 |
重要なのは、三つを競合製品として見るのではなく、役割の異なる構成要素として見ることだ。ER 2が「部屋を片付けるには何をどの順序で行うか」を考え、VLAが「足を一歩前へ出し、手を伸ばし、物をつかむ」という連続動作へ変換する。通信遅延を避けたい場面では、On-Device 2が機体の近くで動作を生成する。
初代から何が変わったのか
初代Gemini Roboticsが強く示したのは、自然言語の指示を理解し、未学習の物体や配置にも対応しながら、ロボットアームで作業する能力だった。Gemini Robotics 1.5では、行動前に考える仕組みや異なる機体への動作転移が強化された。
Gemini Robotics 2では、次の三つが大きな変化である。
上半身から全身へ
従来のデモは固定されたロボットアームや、ヒューマノイドの上半身を中心とするものが多かった。第2世代では、歩行、しゃがみ、姿勢の保持、棚への接近、両手作業を含む全身の協調へ進んだ。
単発操作から数分間の工程へ
物を一つ移すだけでなく、部屋の状態を確認し、複数の物を順番に片付け、失敗したらやり直し、完了条件を判断する。ER 2が数百の判断を含む数分間のタスクを追跡する構成が示された。
一台からチームへ
異なる種類のロボットが作業を分担し、情報を共有する複数ロボット連携が導入された。一台では運べない物や、移動と操作を同時に行う工程で価値が期待される。
全身制御はなぜ難しいのか
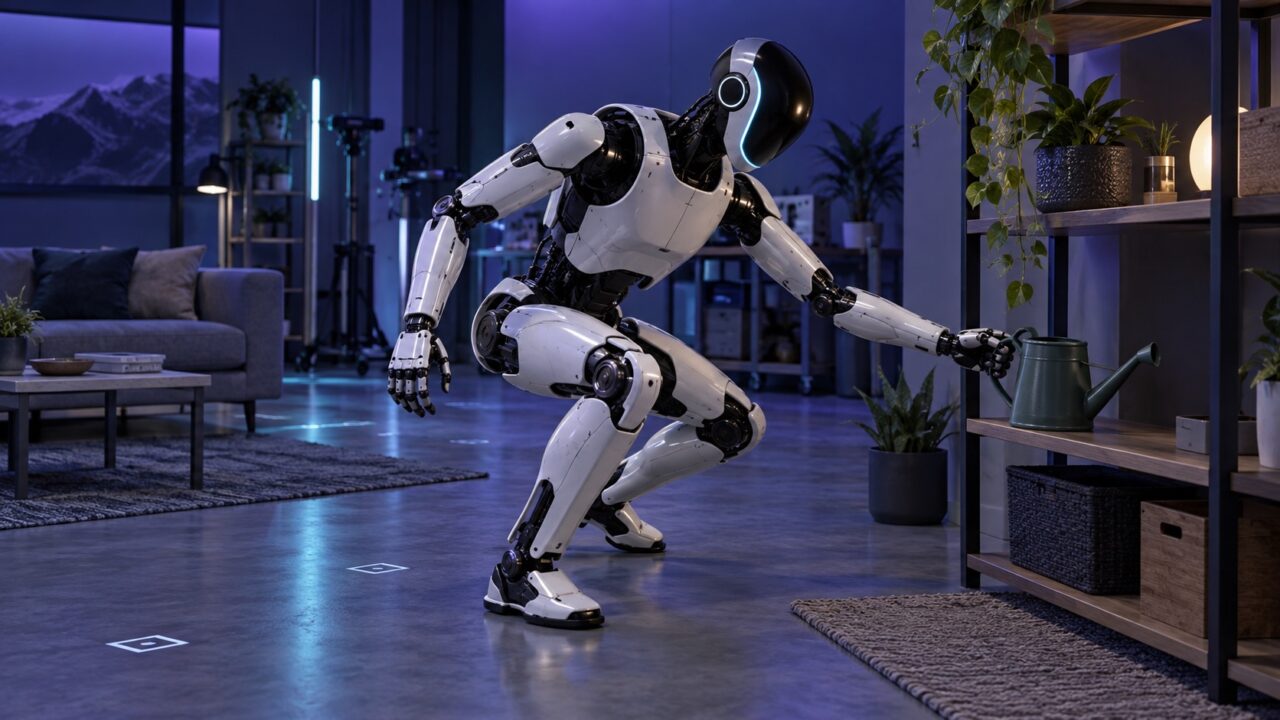
机に固定されたアームなら、土台の位置は変わらない。手先を動かす際も、床との接触や転倒を細かく考えずに済む。一方、ヒューマノイドは足を動かすたびに重心が変わる。手を伸ばした反動で姿勢が崩れ、床の摩擦や荷物の重さによって必要な力も変わる。
例えば「じょうろを下段の緑の箱へ入れる」という指示には、対象物と箱を見つける、近づく、手を伸ばす、持ち上げる、棚へ歩く、しゃがむ、周囲に衝突せず置く、という複数の能力が必要だ。歩行と操作を別々に最適化するだけでは、切り替え時に不自然な停止や姿勢崩れが起きる。
Gemini Robotics 2は、視覚と言語の情報を使いながら、足先から指先までの動作を同じモデルで扱う方向を示した。Google DeepMindはApptronik Apollo 2や、二本のFrankaアームを備えた構成など、異なる機体で同一チェックポイントを使った結果を紹介している。
これは、機体ごとに完全に別の知能を作る負担を減らす可能性がある。ただし、関節数、可動域、センサー、重量、制御周期が異なる機体へそのまま移せるわけではない。低水準の制御、安全制限、追加データによる適応は必要になる。
「器用な手」はどこまで進んだのか
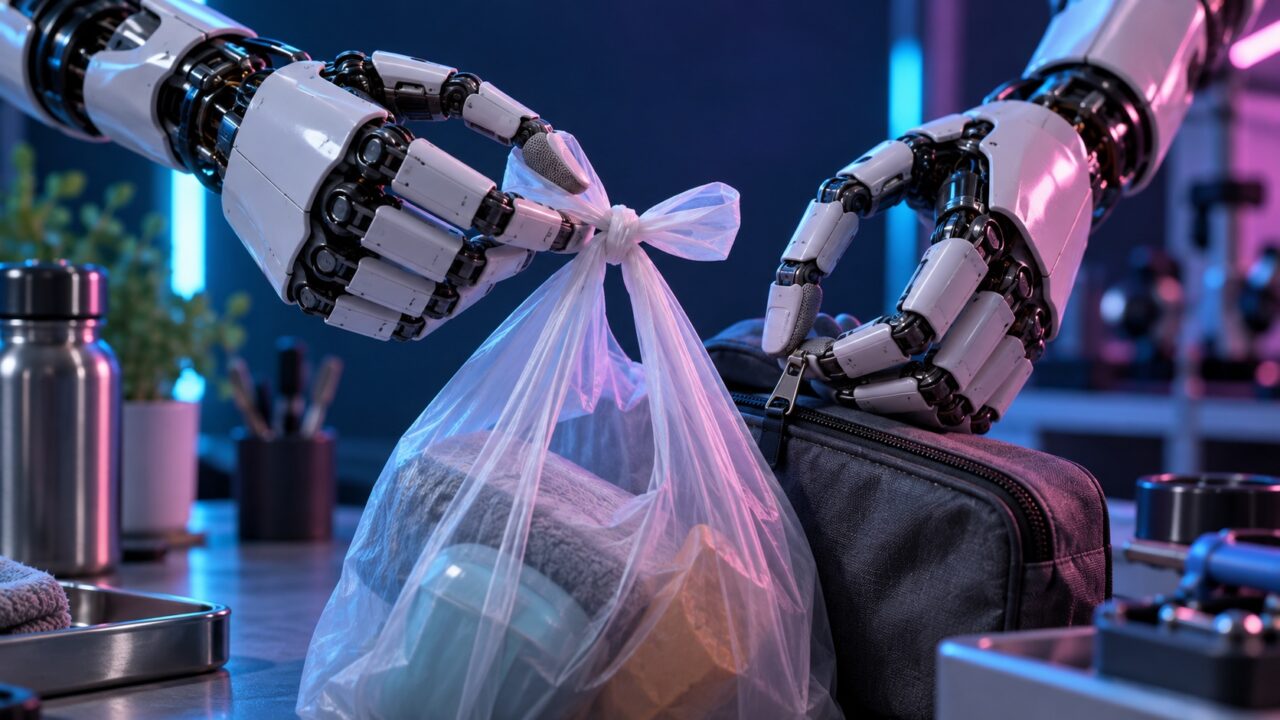
ロボットの手が難しい理由は、接触状態が常に変わるからだ。硬い箱を二本指でつかむ場合と、柔らかい袋を結ぶ場合では、必要な指の配置、力、摩擦、視点が大きく異なる。物体の一部が手で隠れるため、カメラ映像だけで状態を推定することも難しい。
Gemini Robotics 2は、五本指で22自由度を持つSharpaWaveハンドや、一般的な二本指グリッパーでの作業を示した、電球を回す、袋を結ぶ、ジッパー付き袋を閉じる、道具を所定位置へ詰める、部品を挿入するといった課題である。
公式発表のグラフでは、Franka Duoの二本指グリッパーを使った一般的なピック&プレースが74.2%、多様な道具のキッティングが78.9%、精密な挿入作業が89.6%と報告された。これに対し、多指ハンドでは電球を外す作業が92%だった一方、電球を取り付ける作業は36%、袋を結ぶ作業は44%、ちり取りの操作は32%、袋を閉じる作業は40%だった。
この差は重要だ。成功例の映像だけを見ると人間に近い器用さを感じるが、タスクによって再現性は大きく異なる。柔らかい物体、両手の同時接触、長い工程、視界の遮蔽は依然として難しい。企業は平均値だけでなく、失敗の種類、対象物のばらつき、試行回数、復旧方法を見る必要がある。
ER 2は「考える脳」、VLAは「動かす脳」
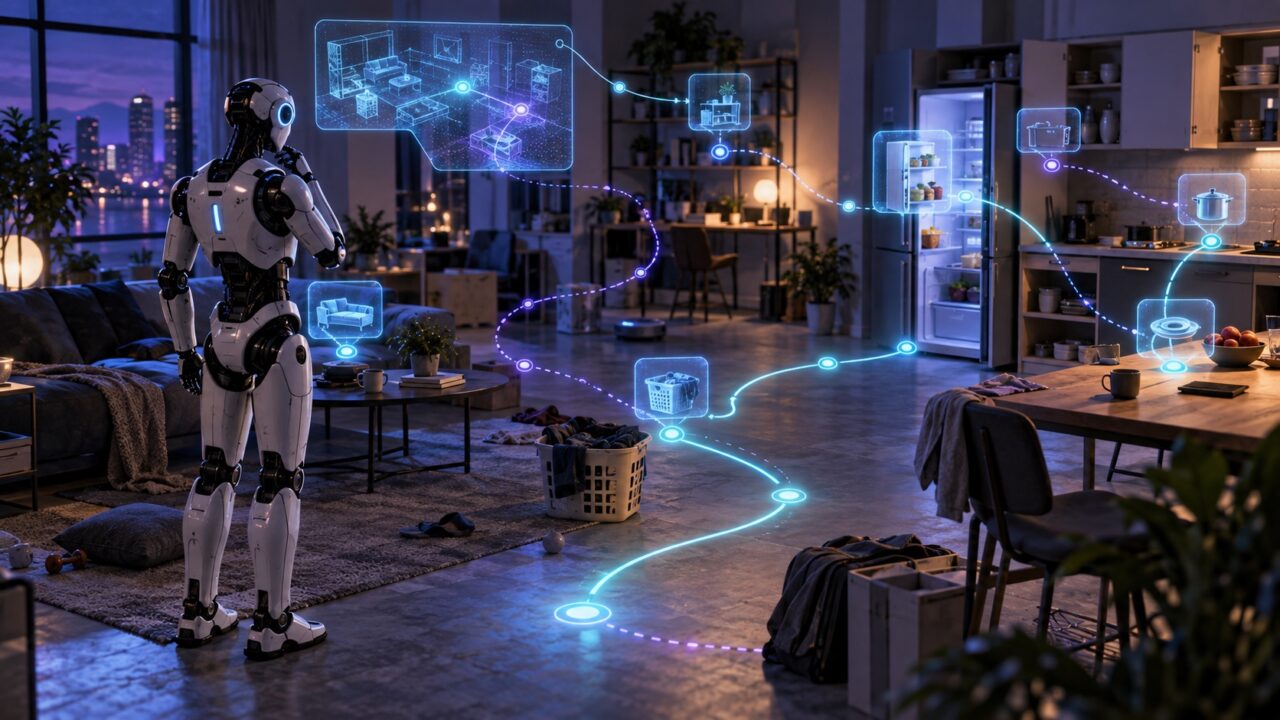
Gemini Robotics ER 2のERはEmbodied Reasoning、つまり身体を持つAIに必要な推論を意味する。画像を説明するだけでなく、空間の位置関係、物体の用途、人との距離、作業の順序、完了条件を理解する。
「散らかった部屋を片付けて」という指示は、そのまま関節角度へ変換できない。ER 2は、床にある物を分類し、収納先を決め、壊れやすい物を先に避け、作業順序を作る。途中で物を落としたら計画を更新し、危険や不確実性が高ければ人へ確認する。
VLAは、ER 2から受け取った中間目標を、連続的な動作へ落とす。カメラで現在の状態を再観測しながら、歩行、腕、手指を制御する。高水準の計画と低水準の制御を分けることで、説明可能性と応答速度の両方を狙える。
この分業は人の組織にも似ている。作業責任者が工程と安全を管理し、現場担当が状況に応じて手を動かす。ただし、AI同士の分業では誤解が連鎖する。ERが対象物を取り違える、VLAが実行不可能な軌道を出す、完了判定が早すぎる、といった失敗を個別に検知する仕組みが必要だ。
複数ロボット連携が意味すること
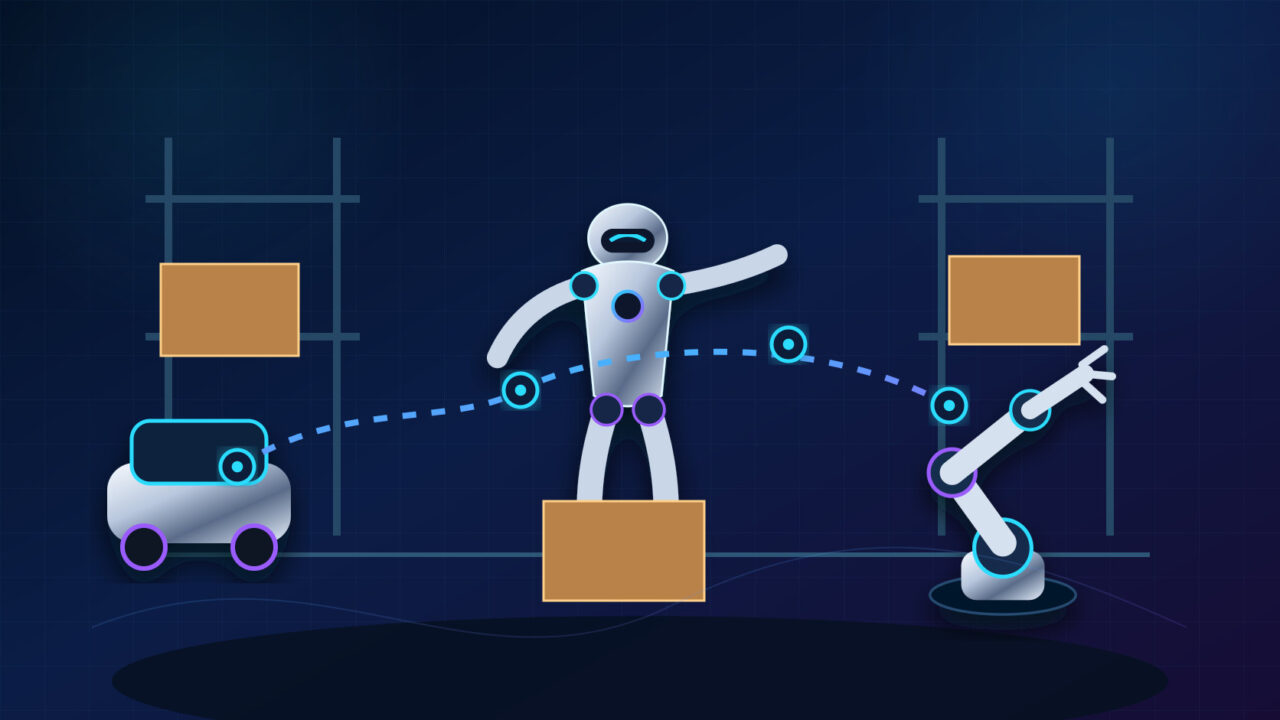
現実の工場や倉庫では、一台ですべてを行うより、得意な機体を組み合わせるほうが合理的である。搬送ロボットは長距離移動、固定アームは高速で正確な反復、ヒューマノイドは人向けに作られた空間への対応を得意とする。
Gemini Robotics ER 2は、異なるロボットが情報を共有し、作業を分担する構成を示した。例えば、移動ロボットが棚から箱を運び、二本腕ロボットが開梱し、別のアームが検査する。一台が遅れたときは順序を組み替える。
複数ロボット連携では、自然言語の理解だけでは足りない。各機体の位置、電池、可搬重量、利用中の道具、立入禁止区域を共通の状態として管理する必要がある。通信が切れた場合の動作、指示の競合、誰が安全停止を決めるかも設計しなければならない。
短期的には、完全に自律したロボットチームより、既存の倉庫管理システムや製造実行システムが作業を割り当て、ERが例外処理と再計画を支援する形が現実的だろう。
On-Device 2が必要な理由
ロボット制御には時間制約がある。人が近づいた、持った物が滑った、床に障害物が現れた、といった変化に対し、クラウドとの往復を待っていては遅い場合がある。通信が不安定な工場、地下、災害現場、家庭では、常時接続を前提にできない。
Gemini Robotics On-Device 2は、機体上で動くことを想定した効率的なVLAである。低遅延、オフライン動作、映像を外部へ送らないプライバシー面の利点がある。
Google DeepMindは、形状、センサー、自由度が異なる新しい二本腕ロボットへ、数時間分、通常200例未満のデータで適応できると説明している。これは事前学習した知識とMotion Transferを使い、新しい機体で最初から大量データを集める負担を減らす考え方だ。
ただし「200例未満」は、あらゆる作業が200回で完成するという意味ではない。公式デモの条件、対象機体、タスク範囲での適応結果であり、製品化には異常時、摩耗、照明変化、作業者の動線を含む追加評価が必要だ。
公開されている性能値をどう読むか
Google DeepMindは、Apollo 2とFranka Duoを使った複数タスクの成功率を公開している。全身操作では、テーブルから取る作業68.4%、床から取る作業45.7%、棚から取る作業76.3%という例が示された。
これらは進歩を示す一方、製造ラインの品質保証をそのまま満たす数値ではない。成功率90%でも、100回に10回は失敗する。家庭なら物を落とす、工場なら設備を止める、医療なら重大な危険につながる可能性がある。
評価を見るときは、次を確認したい。
- 何種類の物体、環境、照明で試したか
- 学習時に似た場面が含まれていたか
- 成功の定義はどこまで含むか
- 失敗時に安全停止・再試行できたか
- 一回の成功にかかった時間はどれくらいか
- 動画は代表例か、連続した全試行か
- 同じモデとと設定で第三者が再現できるか
メーカーのベンチマークは技術の方向を知る材料であり、導入判断そのものではない。自社の物体、通路、作業者、失敗条件を使った評価へ置き換える必要がある。
VLAとは何か
VLA(Vision-Language-Action)は、視覚、言語、行動を一つにつなぐモデルである。カメラ映像で現場を見て、「青い箱を右の棚へ置いて」という指示を理解し、ロボットの手先位置、関節、グリッパーなどの動作列を出力する。
大規模言語モデルが次の言葉を予測するのに対し、VLAは次の行動を予測する。動作をトークンとして扱う方式もあれば、連続値や動作チャンクを生成する方式もある。詳しい仕組みと主要モデルは、9月20日公開予定のVLA総合ガイドで整理する。
VLAだけで万能になるわけではない。現実の未来を予測するワールドモデル、衝突を防ぐ制御器、機体状態を監視するシステム、タスク管理、ログ、人の介入が組み合わさって初めて運用できる。
前回解説したNVIDIA Cosmos 3が「行動した後に世界がどう変わるか」を予測・生成する基盤を重視するのに対し、Gemini Robotics 2は視覚と言語から実際の身体動作を生成する側に重点がある。両者の境界は次第に重なっている。
Cosmos 3やGR00Tとの違い
ロボット基盤モデルは、目的と公開形態が異なる。
| 技術 | 主な焦点 | 特徴 | 2026年9月時点の公開状況 |
|---|---|---|---|
| Gemini Robotics 2 | 全身制御、器用な操作、複数機体 | Geminiの理解とVLAを統合 | VLAは早期アクセス、ER 2はAI Studio等で提供 |
| NVIDIA GR00T N1.6 | ヒューマノイド向けVLA | Cosmos Reasonと連携するオープンモデル | Hugging Face等で公開 |
| NVIDIA Cosmos 3 | 世界理解、未来生成、行動予測 | 合成データとシミュレーションを含む基盤 | モデル・コードを段階的に公開 |
| OpenVLA | 研究・開発用のオープンVLA | 7B、Open X-Embodimentで事前学習 | オープンソース |
Gemini Robotics 2は、Googleの大規模マルチモーダルモデルと実機研究を統合し、異なる機体を同じモデルで扱うことに強みがある。一方、利用には早期アクセスや提携が必要な部分があり、モデル内部や学習データを自由に改変できるオープンモデルとは条件が違う。
企業はデモの印象だけでなく、利用可能性、ライセンス、対応機体、推論環境、データを外へ出せるか、保守期間を比較すべきだ。
どの産業で使われるのか
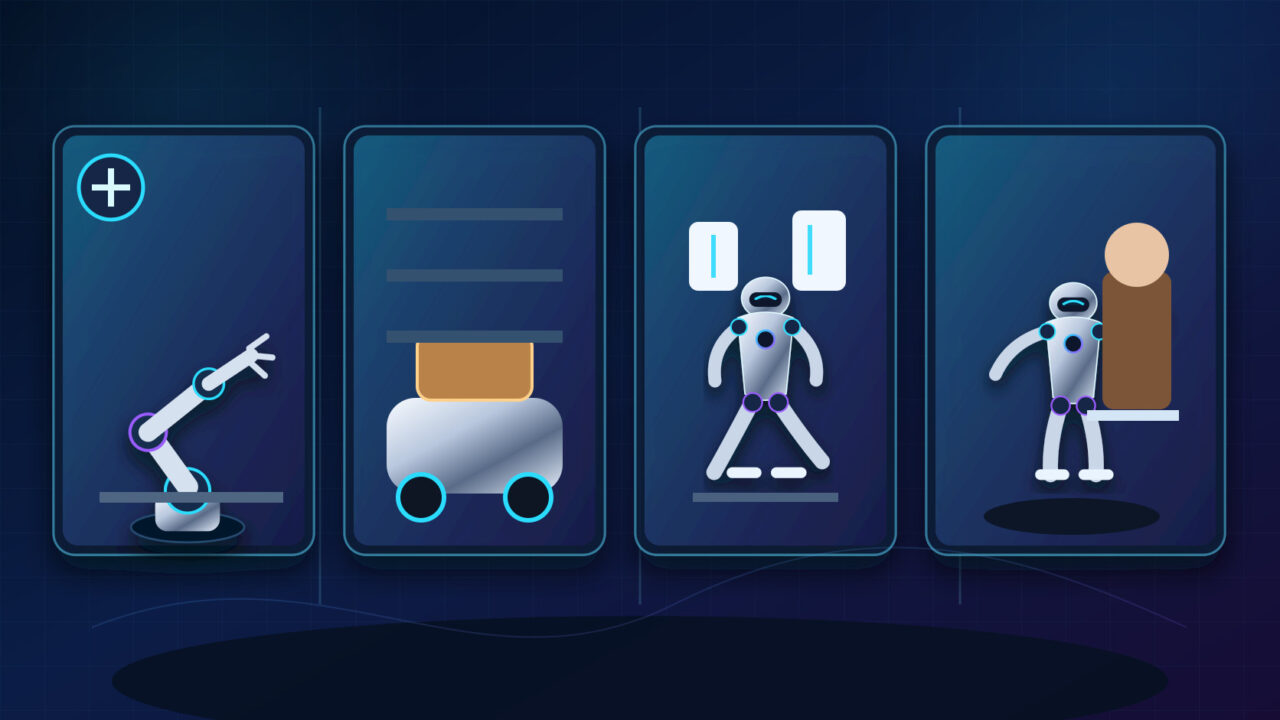
製造業
部品供給、箱詰め、治具への挿入、工具の受け渡し、ライン変更時の再学習に使える可能性がある。全身移動が必要な既存工場では、固定アームを追加しにくい工程への応用が考えられる。
物流・倉庫
棚からの取り出し、床の落下物の回収、箱の開閉、搬送ロボットとの協働に向く。商品形状と配置が頻繁に変わるため、言語指示と汎化能力の価値が大きい。
店舗・宿泊
補充、清掃、バックヤード運搬、閉店後の片付けなど、人向けに設計された空間を使う作業が対象になる。来店者の動きとプライバシーへの配慮が不可欠だ。
病院・介護
物品搬送、リネン回収、備品補充など非医療行為から導入が進む可能性がある。人への直接接触を伴う作業は、技術だけでなく認証、責任、感染管理、説明と同意が必要になる。
災害・インフラ点検
通信が不安定な場所でOn-Deviceモデルを使い、移動と操作を組み合わせる可能性がある。ただし、未知の地形や損傷設備は学習分布から外れやすく、遠隔操作との併用が現実的だ。
安全性はどう設計されているか
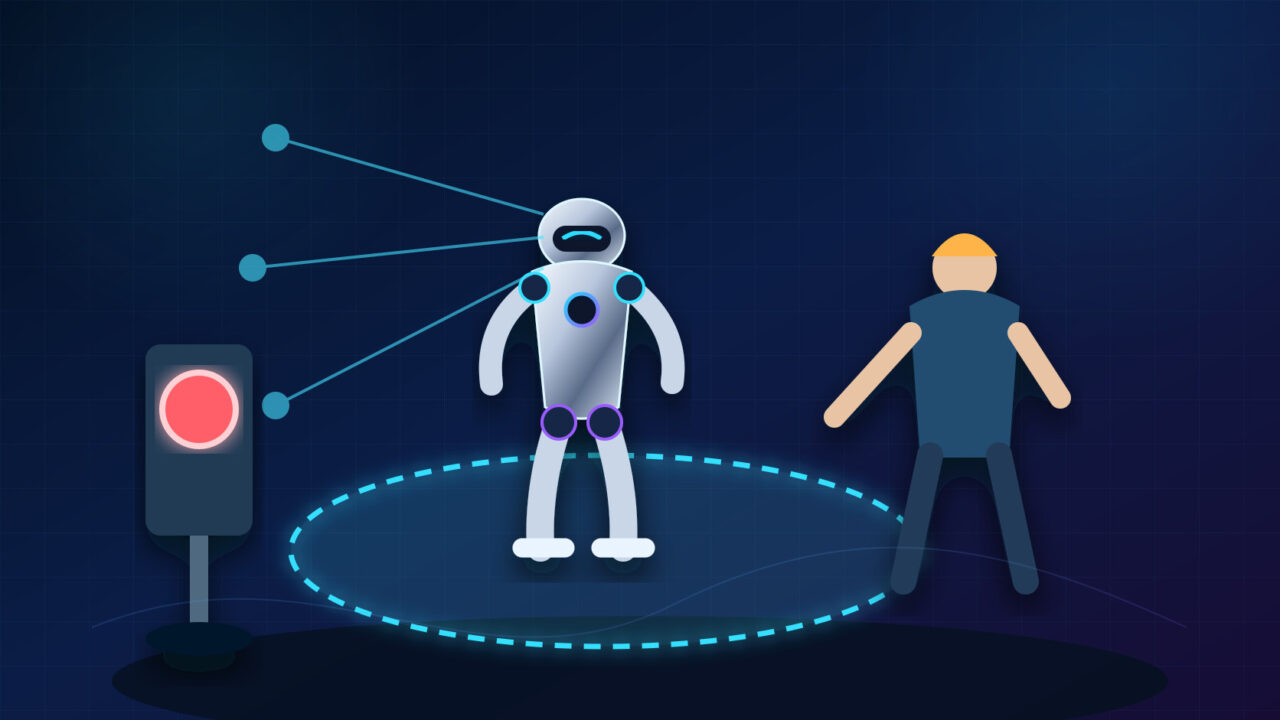
Google DeepMindは、従来の機械安全とAI安全を組み合わせる多層構成を掲げている。Gemini Robotics ER 2は、人との距離やタスクの危険性を理解し、安全ツールを呼び出し、不確実な場合に人へ介入を求める能力を強化したと説明されている。
また、危険なVLAツール呼び出しを拒否できるか、実行不可能な指示を判断できるか、不確実性に対して人へ相談できるかを測るASIMOV-Agenticベンチマークが導入された。
それでも、言語モデルの判断を唯一の安全装置にしてはならない。実装では少なくとも次の層が必要になる。
- 機械的なトルク・速度・可動域の制限
- 人や設備との距離を監視する独立センサー
- AIから独立した非常停止と安全PLC
- 許可された作業・道具・区域の制限
- 異常時に動力を落とすフェイルセーフ
- 全行動とセンサー状態の記録
- 人が再開を承認する運用手順
AIが「安全だと思う」ことと、機械が規格に基づいて安全であることは同じではない。モデルの安全評価、機体の安全設計、現場のリスクアセスメントを分けて実施する必要がある。
現在の限界
成功率がタスクごとに大きく違う
棚から物を取れるモデルでも、柔らかい袋を結ぶ、透明物を扱う、狭い隙間へ挿入するといった作業は難しい。平均値では弱点が見えにくい。
動作速度が人に及ばない
慎重な動作は安全に見える一方、生産性へ直結する。人の数倍の時間がかかるなら、機体価格が下がっても採算が合わない可能性がある。
長時間になるほど失敗が積み重なる
一工程99%でも、100工程をすべて成功する確率は約36.6%に下がる。再観測、やり直し、中間確認、人への引き継ぎが必要だ。
現場固有データが必要になる
汎用モデルでも、対象物、照明、手袋、棚、床、機体に合わせた追加学習と評価は避けられない。データ収集とラベル付けの費用が残る。
利用範囲が限定される
2026年9月時点で、Gemini Robotics 2とOn-Device 2のVLAは早期アクセスパートナー向けであり、誰でも同じモデルをすぐ実機へ導入できる状態ではない。ER 2はGoogle AI Studioで利用できるが、低水準のロボット制御とは別である。
企業がPoCで確認すべき12項目
- 対象タスクの開始・終了・成功条件を定義したか
- 未学習の物体、配置、照明で評価したか
- 一時間あたりの処理数が業務要件を満たすか
- 失敗を自分で検知し、安全に再試行できるか
- 人が近づいたとき規定時間内に停止できるか
- 通信断、カメラ遮蔽、センサー故障を試したか
- 何例の現場データと何時間の調整が必要か
- 映像・音声・作業ログの保存場所と権限は明確か
- クラウド停止時も安全に終了できるか
- 機体・モデル・周辺設備を含む総保有コストはいくらか
- モデル更新後に再認証・再評価する手順があるか
- 事故時の責任分界とログの保全方法を決めたか
デモでは成功した一回が目立つ。PoCでは連続試行の分布、失敗後の復旧、最悪条件を記録することが重要である。
日本企業にとっての意味
日本には、産業用ロボット、減速機、センサー、工作機械、品質保証、保守の強い企業が多い。Gemini Robotics 2のような汎用知能が進歩すると、価値の中心が「機体を一台売る」ことから、「現場データで適応させ、安全に運用し続ける」ことへ広がる。
特に、人手不足が深刻な物流、食品、宿泊、介護、建設では、人が使う設備を大きく変えずに作業できるロボットへの期待が高い。一方、現場は企業ごとに例外が多く、英語圏の家庭や研究室で学んだモデルをそのまま使えるとは限らない。
日本企業の競争力は、世界最大の基盤モデルをゼロから作ることだけではない。GoogleやNVIDIAの基盤モデルへ、現場の作業知識、小型で信頼性の高い機体、安全規格、保守網を組み合わせることにある。「ロボティクス大国・日本の逆襲」で述べた実装力が、より重要になる。
2026年から2030年に起こりそうな変化
以下は現在の技術動向から考えられるシナリオであり、確定した予測ではない。
機体をまたぐ共通モデルが増える
一つのチェックポイントを複数機体へ適応し、共通の知識と作業表現を再利用する。機体ごとの追加学習は残るが、ゼロから作る割合は減る。
高水準のERと低水準のVLAが標準構成になる
計画、対話、ツール利用は大きなモデル、低遅延の制御は小さなオンデバイスモデルが担当する。クラウドとエッジの分業が一般化する。
ロボットチームの運用ソフトが重要になる
複数ロボットの能力、位置、電池、仕事を管理し、人へ説明する仕組みが必要になる。モデル単体より、全体を止めずに運用する基盤が差になる。
評価がデモ動画から稼働KPIへ移る
成功率だけでなく、処理量、介入回数、安全停止、復旧時間、消費電力、保守費、廃棄率で比較される。現場の数字を公開できる企業が信頼を得る。
よくある質問
Gemini Robotics 2は一般ユーザーが使えますか
ER 2はGoogle AI Studioで利用できるが、ロボットを直接制御するGemini Robotics 2とOn-Device 2は、2026年9月時点で早期アクセスパートナー向けである。対応機体と契約条件の確認が必要だ。
Geminiアプリから家庭用ロボットを動かせますか
通常のGeminiアプリとロボット向けモデルは別である。機体のセンサー、制御器、安全系、開発インターフェースを接続しなければならない。
インターネットがなくても動きますか
On-Device 2はローカル実行を想定している。ただし、機体への導入、更新、ログ管理、対応ハードウェアなどの条件がある。すべての機能が完全オフラインになるとは限らない。
どんなロボットでも数時間で対応できますか
公式発表は、対象となった二本腕機体などで、通常200例未満、数時間のデータによる適応を示したものだ。まったく異なる移動方式、センサー、作業、安全要件では追加開発が必要になる。
人間と同じ速さと器用さがありますか
まだない。特定の作業では高い成功率を示すが、多指の細かな操作や長い工程は成功率にばらつきがあり、動作速度も課題として公式に認められている。
仕事をすぐ置き換えますか
短期的には、仕事全体ではなく、危険、反復、夜間、運搬などの工程単位で導入される可能性が高い。人は例外対応、監督、品質判断、顧客対応、保守を担う。
まとめ——ロボットの知能は「腕」から「全身とチーム」へ
Gemini Robotics 2は、ロボットAIの対象を、テーブル上の単発操作から、歩行を含む全身動作、両手と多指の器用な作業、数分間の計画、複数ロボット連携へ広げた。
その核は、現場を理解して計画するER 2と、視覚・言語を連続動作へ変えるVLA、機体上で低遅延に動くOn-Device 2の分業にある。大きなモデルがすべてを直接制御するのではなく、考える層と動く層をつなぎ、途中で観測と計画を更新する。
一方、公式の成功率はタスクによって大きく異なり、多指操作、速度、長時間の安定性には課題がある。早期アクセスの制約もあり、発表直後に万能ロボットが普及するわけではない。
重要なのは、最も印象的なデモを選ぶことではない。自社の現場で何回成功し、どう失敗し、何秒で安全停止し、誰が復旧できるかを測ることだ。Gemini Robotics 2はロボットの可能性を大きく広げたが、現実の価値を決めるのは、モデル、機体、安全、運用を一つの仕組みにできるかである。
参考資料
- Google DeepMind「Gemini Robotics 2 brings whole body intelligence to robots」
- Google DeepMind「Gemini Robotics: Bringing AI into the Physical World」
- Google DeepMind「Gemini Robotics On-Device」
- Google DeepMind「RT-2: New model translates vision and language into action」
- NVIDIA「New Physical AI Models」