ここ数年、AIの話題は「より大きなモデル」を中心に進んできた。パラメータを増やし、学習データを増やし、巨大なデータセンターで動かす。その方向は確かに性能を押し上げたが、同時に別の現実も見えてきた。応答が遅い、費用が読めない、社外にデータを出せない、通信が切れると何もできない――現場で使おうとした途端に立ちはだかる壁である。
そこで存在感を増しているのがSLM(Small Language Model/小規模言語モデル)だ。数億から数十億パラメータ規模の軽量なモデルを、スマートフォン、PC、産業機器、ロボット、あるいは社内サーバーで動かす。最先端の巨大モデルに全面的に勝つわけではないが、用途を絞れば「十分な品質を、速く、安く、手元で」出せるという点で評価されている。
ロボティクスの分野でも、機体の上で動く軽量モデルが重視され始めた。通信の往復を待たずに判断し、ネットワークが不安定でも動き続けることが、現実世界で作業する機械には欠かせないからだ。
本稿では、SLMの定義と大規模モデルとの関係、注目される理由、小さくするための技術、動作環境、得意・不得意、大規模モデルとの組み合わせ方、導入手順と評価の考え方、そして残る課題までを、2026年9月時点の情報をもとに整理する。製品名や性能値は更新が速いため、採用前には必ず最新の公式情報を確認してほしい。
この記事の要点
- SLMは、用途を絞って軽量に動かすことを狙った言語モデルの総称である
- パラメータ規模の明確な線引きはなく、「端末や小さなサーバーで動かせる大きさ」という実用的な定義が使われる
- 注目される理由は、費用、応答速度、プライバシー、オフライン動作、消費電力の五つに集約される
- 蒸留、量子化、枝刈り、学習データの質の向上が、小型化を支える主要な技術である
- 広い知識や複雑な推論は大規模モデルに分があり、役割分担が前提になる
- 導入は、用途の選定→評価データの作成→調整→量子化→配布→監視という流れで進める
- 公開ベンチマークの点数ではなく、自社業務のデータで評価することが成否を分ける
SLM(小規模言語モデル)とは何か
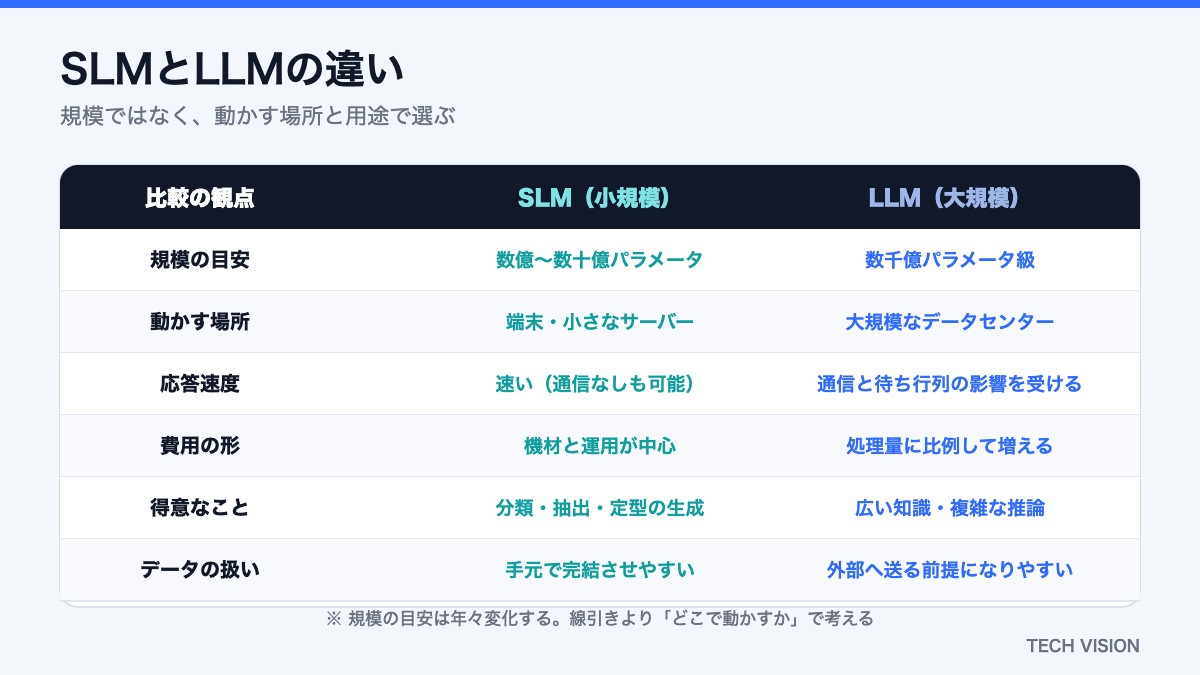
SLMは、大規模言語モデル(LLM)に対して、パラメータ数を抑え、少ない計算資源で動作するよう設計された言語モデルを指す。明確な閾値が定められているわけではないが、実務では「一般的なGPUを一枚、あるいは端末の処理装置だけで動かせる規模」という感覚で使われることが多い。
「小さい」の基準は移り変わる
数年前であれば数十億パラメータは大きい部類だった。しかし、数千億規模のモデルが当たり前に語られるようになった今、同じ規模が「小さい」側に分類される。基準は相対的で、年々ずれていくことを前提に読む必要がある。
小型化は性能の妥協ではない
重要なのは、SLMが単に「劣化版の大規模モデル」ではない点である。学習データの質を高め、対象領域を絞り、用途に合わせて調整することで、特定の作業では大規模モデルに匹敵する結果を出す例も珍しくない。汎用の賢さを求めるのか、限定された仕事の確実さを求めるのか――目的の違いが選択を分ける。
オンデバイスAIとの関係
SLMは、端末の上で推論するオンデバイスAIを実現する中心的な部品でもある。スマートフォンの文章要約、PCの補完機能、家電の音声操作、ロボットの状況判断など、クラウドに送らずに完結させたい処理が主な対象になる。
AIを載せた身近な専用デバイスとしては、会話を録音して文字起こしや要約までこなすAI議事録デバイスも普及し始めている。「AIを持ち歩く」使い方は、今後さらに広がっていくだろう。

PR:Plaud(AI議事録デバイス)
なぜ今、SLMが注目されるのか
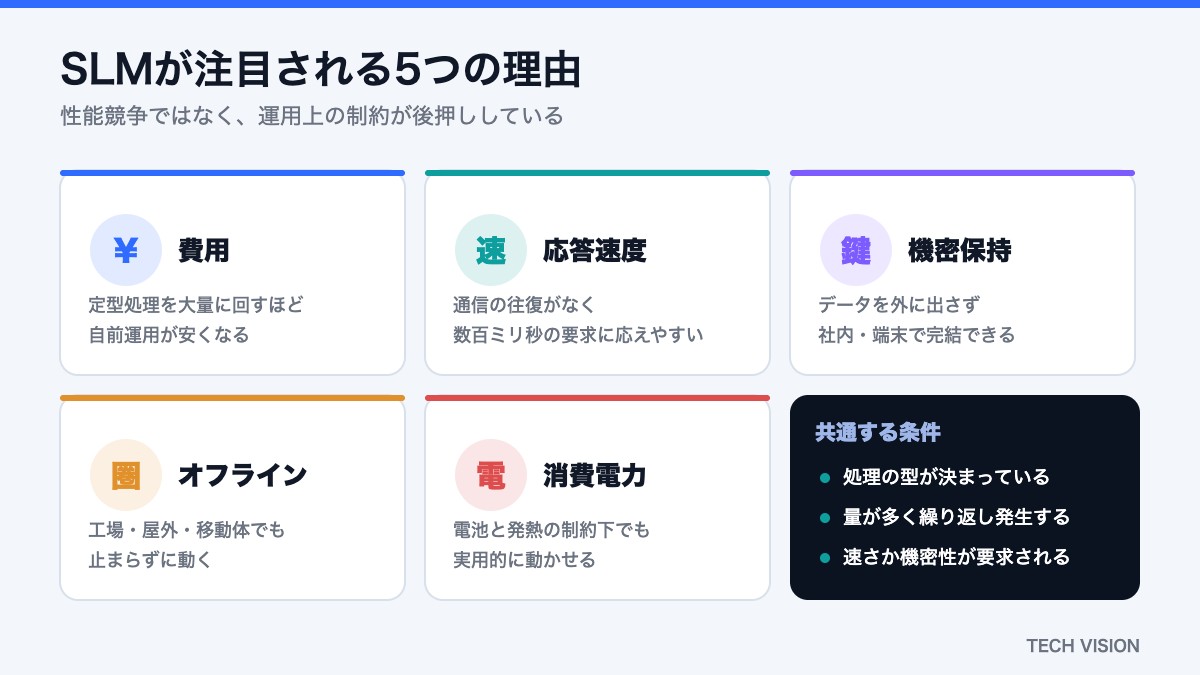
理由は技術的な流行ではなく、運用上の制約にある。大きく五つに整理できる。
1. 費用
大規模モデルのAPIは便利だが、処理する文章量に比例して費用が積み上がる。問い合わせ分類や定型文の生成のような単純で大量に発生する処理では、軽量モデルを自前で動かしたほうが安く収まる場合が多い。
2. 応答速度
クラウド経由の処理は、通信の往復と待ち行列の時間が加わる。音声対話や機器の制御のように数百ミリ秒の遅れが体験を壊す用途では、手元で動く小さなモデルの価値が大きい。
3. プライバシーと機密保持
医療、金融、公共、製造などでは、データを外部へ出せない制約がある。端末や社内環境で完結できれば、持ち出し自体が発生しないという形で要件を満たせる。
4. オフラインでも動くこと
工場、地下、山間部、災害時、移動体――通信が不安定な環境は現実に多い。ネットワークに依存しない処理は、可用性の面で明確な利点になる。
5. 消費電力と発熱
データセンターの電力需要が社会的な論点になる一方、端末側でも電池の消耗と発熱は無視できない。小さなモデルは消費電力あたりの実用性という観点で選ばれる。
背景:規模の追求から、効率の追求へ
SLMの台頭は突然起きたわけではなく、ここ数年のAI開発の流れの延長線上にある。
「大きくすれば強くなる」の先へ
モデルの規模、データ量、計算量を増やすほど性能が上がるという経験則が、開発競争を牽引してきた。しかしその後、同じ計算量なら、データの量と質の配分を見直したほうが効率が良いという知見が広がり、規模一辺倒の設計は見直されていった。小さなモデルでも、学習の設計次第で十分な性能に届くという実証が積み上がったのがこの時期である。
費用の重心が学習から推論へ移った
モデルを一度学習させる費用は大きいが、サービスとして長く使えば、毎回の推論にかかる費用の合計のほうが上回っていく。利用が広がるほど、一回あたりの計算量を削る価値が高まる。SLMは、この構造変化に対する現実的な答えでもある。
端末側の性能向上
スマートフォンやPCに搭載される演算装置は、AI処理を前提とした設計が進んだ。数年前なら端末で動かすのが難しかった規模のモデルが、実用的な速度で動くようになったことが、オンデバイスAIの前提条件を整えた。
どうやって小さくするのか:主要な技術
SLMは「小さく作る」だけでなく、「大きなモデルから小さく写し取る」手法も含めて発展してきた。
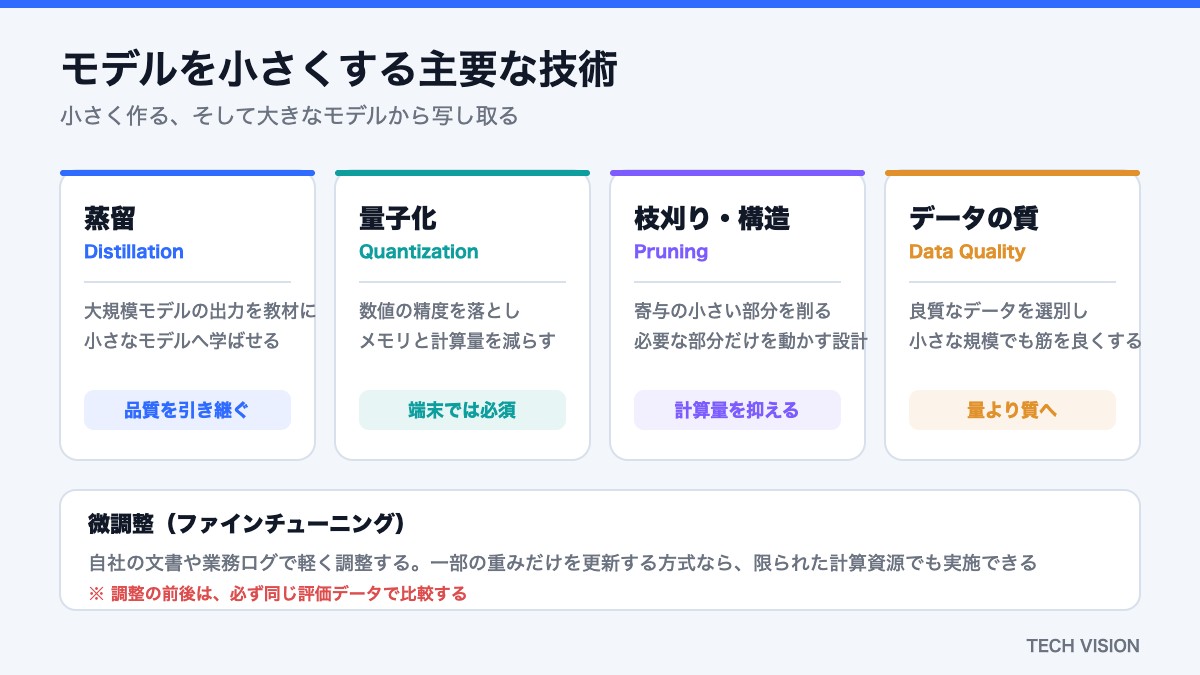
蒸留(Distillation)
大規模モデルの出力や判断の傾向を、小さなモデルに学ばせる手法である。教師役の出力を教材にすることで、同じ規模を一から学習させるより高い品質に到達しやすい。対象領域を絞るほど効果が出やすい。
量子化(Quantization)
モデル内部の数値表現の精度を落とし、必要なメモリと計算量を減らす手法である。16ビットから8ビット、4ビットへと下げるほど軽くなる一方、精度の低下が用途に耐えるかの見極めが必要になる。端末で動かす際にはほぼ必須の工程である。
枝刈り(Pruning)と構造の工夫
寄与の小さい部分を削る枝刈りや、計算の一部だけを使う構造の採用など、モデルの作り自体を効率化する研究も進む。推論時に必要な部分だけを動かす設計は、実効的な計算量を抑える方向として定着しつつある。
学習データの質
近年もっとも効果が大きいと言われるのが、データの選別である。教科書的に整理された良質なデータを使うことで、小さな規模でも筋の良い挙動を獲得できることが示されてきた。量より質という方向転換が、SLMの実用性を押し上げている。
微調整(ファインチューニング)
自社の文書や業務ログを使って軽く調整する手法も広く使われる。全体を学習し直さずに一部の重みだけを更新する方式なら、限られた計算資源でも現実的に実施できる。
SLMはどこで動くのか
「小さい」ことの意味は、動かす場所を選べる点にある。
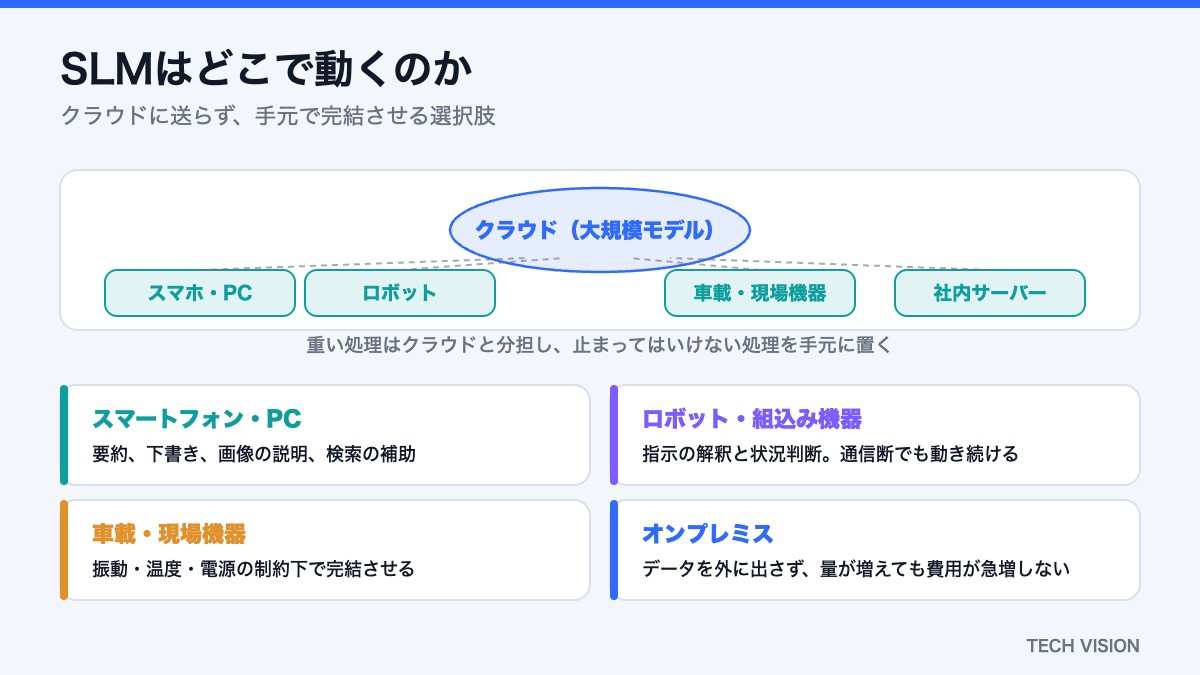
スマートフォン・PC
近年の端末には、AI処理に適した演算装置が搭載されている。文章の要約、下書き、画像の説明、検索の補助といった機能が端末内で完結すれば、通信の有無や利用回数を気にせず使える。
ロボット・組込み機器
ロボットでは、機体上での判断が安全性と直結する。指示の解釈や状況の説明を軽量モデルが担い、重い計画処理はクラウド側と分担する構成が検討されている。通信断でも最低限の動作を続けられることが要件になる領域だ。
車載・現場機器
車両、建機、検査装置などでも、手元で完結する処理の需要は大きい。振動、温度、電源の制約がある環境では、計算資源の少なさを前提にした設計が求められる。
オンプレミス・専用サーバー
端末ではなく社内サーバーで動かす形もSLMの主要な使い方である。データを外に出さず、利用量が増えても費用が線形に膨らまない点が評価される。
得意なこと・苦手なこと
選定の失敗は、たいてい期待値のずれから生じる。向き不向きを押さえておきたい。
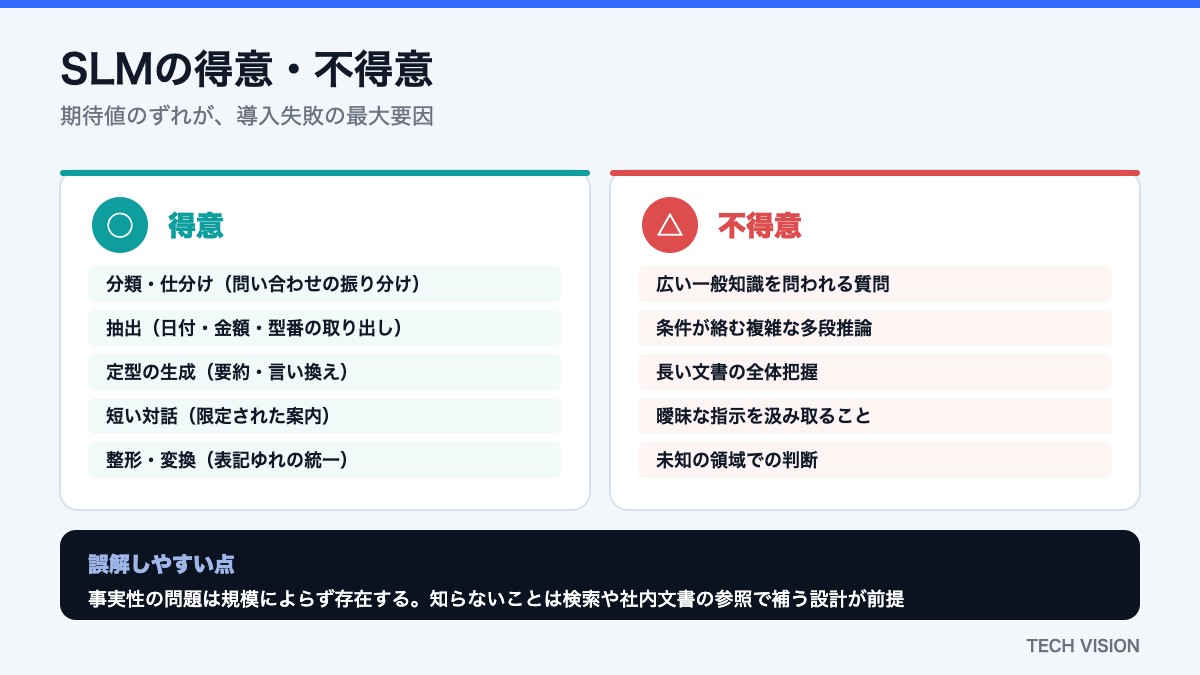
得意な領域
- 分類・仕分け:問い合わせの振り分け、優先度の判定、タグ付け
- 抽出:書類から日付、金額、型番などを取り出す
- 定型の生成:決まった形式の文章、要約、言い換え
- 短い対話:用途が限定された案内や操作の受け付け
- 整形・変換:表記ゆれの統一、形式変換
苦手な領域
- 広い一般知識:学習していない事柄の質問には弱い
- 複雑な多段推論:条件が絡む長い思考は誤りが増えやすい
- 長文の全体把握:扱える文脈の長さと精度に制約がある
- 曖昧な指示の補完:言葉足らずな依頼を汲む力は大規模モデルに劣る
誤解しやすい点
「小さいモデルは嘘をつきやすい」と単純化されがちだが、事実性の問題は規模にかかわらず存在する。むしろ重要なのは、知らないことを外部データで補う設計である。検索や社内文書の参照と組み合わせれば、小さなモデルでも十分に実用的な回答を返せる。
大規模モデルとの組み合わせ方
実務では「SLMかLLMか」という二者択一ではなく、組み合わせが前提になる。
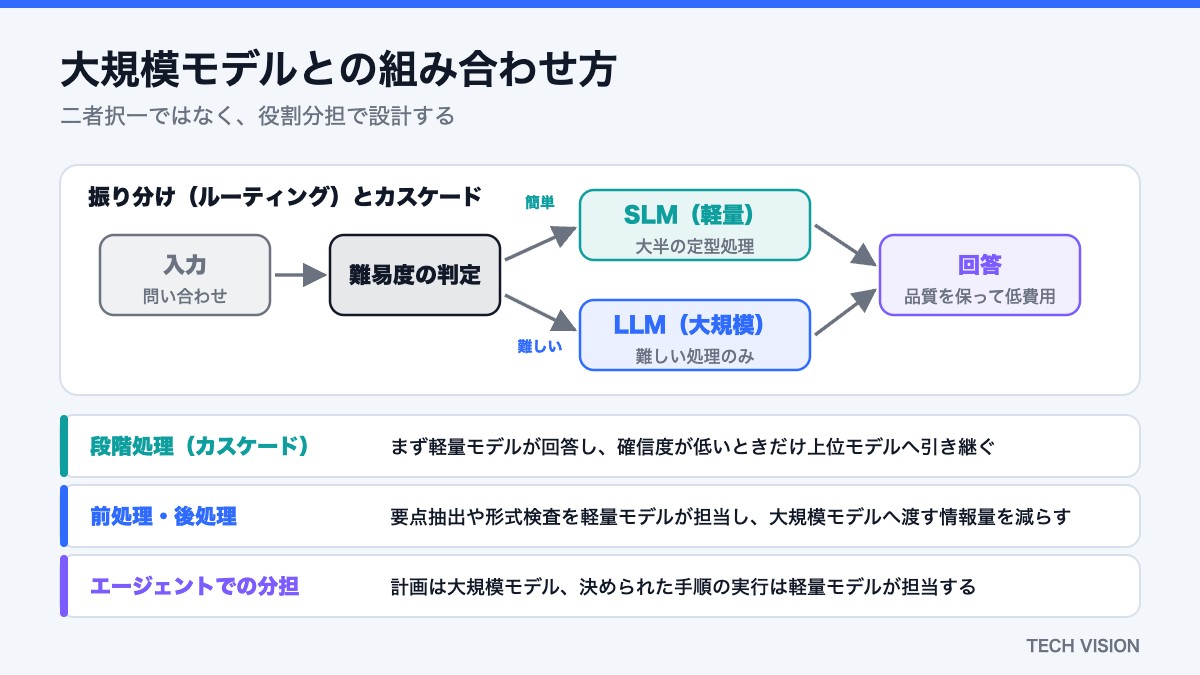
振り分け(ルーティング)
入力の難易度を判定し、簡単なものは軽量モデル、難しいものは大規模モデルへ回す方式である。大半の処理が定型であるほど、費用の削減効果が大きい。
段階処理(カスケード)
まず軽量モデルが回答し、確信度が低い場合のみ上位モデルに引き継ぐ。品質を保ちつつ平均費用を下げる現実的な構成である。
前処理・後処理としての利用
長い文書の要点抽出、不要部分の除去、出力の形式検査といった周辺処理を軽量モデルに任せると、大規模モデルへ渡す情報量が減り、費用と遅延の両方が下がる。
エージェント構成での分担
複数の処理を自動で進めるエージェントでは、計画を立てる部分と、決められた手順を実行する部分を分けられる。計画は大規模、実行は軽量という分担は、速度と費用の面で理にかなっている。
領域別に見るSLMの使われ方
実際にどんな現場で使われているのか、代表的な領域を挙げる。共通しているのは、処理の型が決まっていて、量が多く、速さか機密性が求められるという条件だ。
顧客対応:一次仕分けと下書き
問い合わせの内容を分類し、担当部署へ振り分け、定型的な返信の下書きを作る。判断が難しいものだけを人や上位モデルへ回す設計にすれば、対応速度を落とさずに費用を抑えられる。過去の対応履歴を参照させると精度が上がる。
製造・保守:現場端末での支援
設備の点検記録を音声から整形する、手順書から該当箇所を探す、異常の報告文を作る。通信環境が不安定な工場や屋外では、端末内で完結する処理の価値が高い。専門用語が多い領域ほど、自社データでの調整が効く。
医療・金融:持ち出せないデータの処理
書類の要約、項目の抽出、記録の整形といった作業は、外部に出せないデータを扱うことが多い。社内環境で動く軽量モデルであれば、データを持ち出さずに自動化できる。もっとも、最終的な判断を人が確認する運用は欠かせない。
ロボティクス:機体の上での判断
指示の解釈、状況の言語化、次の行動の選択といった処理を機体上で行えば、通信の遅延や切断に左右されにくくなる。重い計画処理はクラウドと分担し、止まってはいけない部分を手元に置く構成が現実的である。
個人の端末:日常の小さな支援
メールの要約、文章の言い換え、写真の説明、検索の補助。どれも単体では小さな機能だが、通信や課金を気にせず使えることで利用頻度が上がる。端末メーカーが競って搭載を進めている領域でもある。
導入のステップ
SLMの導入は、モデル選びから始めると失敗しやすい。順序が重要である。
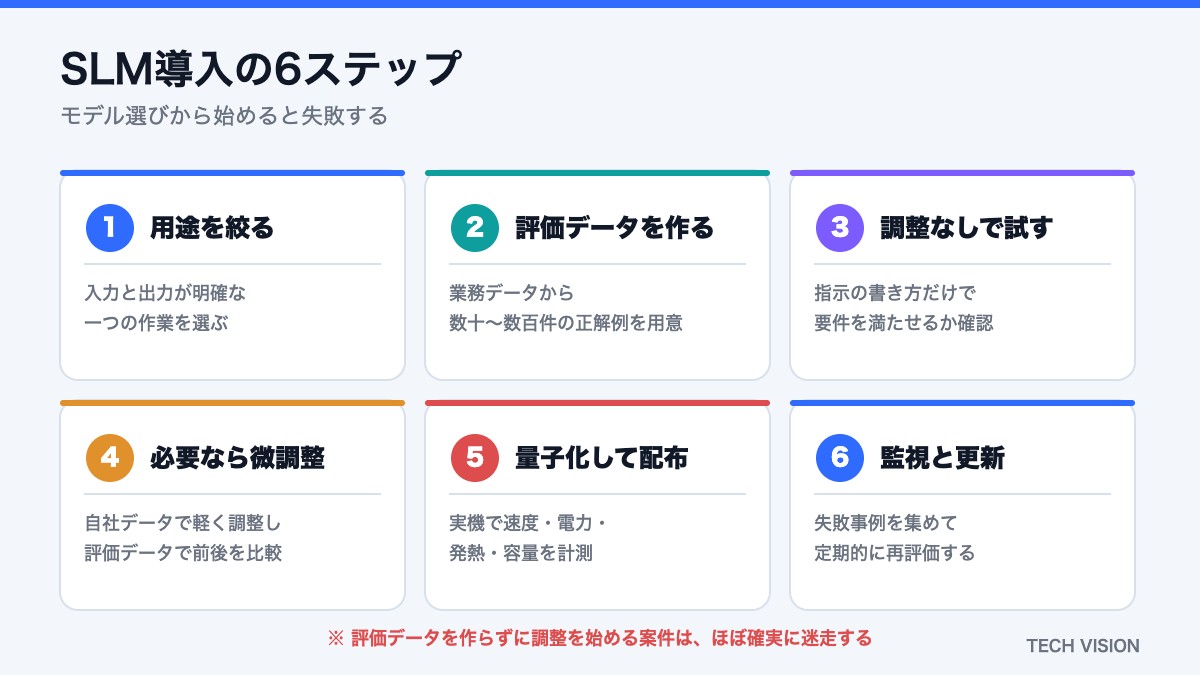
ステップ1:用途を絞る
「社内の何でも相談窓口」ではなく、入力と出力が明確な一つの作業を選ぶ。問い合わせの分類、報告書からの項目抽出、定型メールの下書きなどが典型である。
ステップ2:評価データを先に作る
実際の業務データから数十件から数百件の正解例を用意する。評価の物差しがないまま調整しても、良くなったかどうか判断できない。ここを省く案件は、ほぼ確実に迷走する。
ステップ3:まず調整なしで試す
いくつかの候補モデルに、指示の書き方(プロンプト)だけで挑ませる。これで要件を満たせるなら、学習の工程を省ける。最も安い解決策から順に試すのが鉄則である。
ステップ4:必要なら微調整する
精度が足りない場合に、自社データで軽く調整する。一部の重みだけを更新する方式なら、比較的小さな計算資源で実施できる。ここでも、評価データで前後を比較することが欠かせない。
ステップ5:量子化して配布する
端末で動かす場合は、精度と速度の兼ね合いを見ながら量子化する。実機での速度、消費電力、発熱、記憶容量を計測し、実利用に耐えるかを現物で確認する。
ステップ6:監視と更新の仕組みを作る
導入後も入力の傾向は変わる。失敗した事例を集め、定期的に評価をやり直し、必要に応じて調整する。モデルの更新をどう配布するかも、端末側で動かす場合は設計項目になる。
どんな選択肢があるのか:系統で整理する
個々の製品名は入れ替わりが速いため、ここでは大きな系統として押さえておきたい。
大手が公開する小型モデル
主要なAI企業やクラウド事業者は、旗艦モデルと並行して軽量版を提供している。品質と安定性のバランスが取りやすく、クラウド側の同系統モデルへ切り替えやすい点が利点である。
オープンウェイトの系統
重みが公開され、自社環境で動かせるモデル群である。改変や量子化の自由度が高く、端末やオンプレミスで動かしたい場合の中心的な選択肢になる。利用条件はモデルごとに異なるため、ライセンスの確認が必須である。
日本語に強いモデル
国内の研究機関や企業が公開する、日本語データを重視したモデルもある。日本語の業務文書や敬語表現を扱う用途では、規模が小さくても実用的な品質になることがある。
用途特化のモデル
コード、医療、法務など、領域を絞って学習されたモデルも増えている。汎用性は低いが、対象領域では小さな規模で高い精度を出せるため、業務が明確なら有力な候補になる。
モデルを選ぶときのチェック項目
候補は多いが、見るべき点は絞られる。次の六つを確認すれば、大きく外すことは少ない。
1. ライセンスと商用利用の条件
商用利用の可否、再配布の条件、派生モデルの扱い。ここが合わないと、どれだけ性能が良くても採用できない。最初に確認したい項目である。
2. 日本語の扱い
多言語対応をうたっていても、日本語の品質には差がある。敬語、専門用語、表記ゆれを含む自社の実データで確かめるのが確実だ。
3. 扱える文脈の長さ
長い文書を渡したい場合は、対応する長さと、長くしたときの精度低下を確認する。仕様上の上限と、実用的な上限は一致しないことが多い。
4. 量子化したときの挙動
端末で動かす前提なら、量子化済みの形式が用意されているか、実機でどれだけ速度が出るかを見る。公開されている実測値より、自分で測った値を信じたい。
5. 更新の継続性
提供元が改良を続けているか、不具合への対応があるか。短命なモデルに業務を載せると、更新できないまま取り残される。
6. 差し替えやすさ
特定のモデルに強く依存しない作りにしておく。入出力の形式を抽象化しておけば、より良いモデルが出たときに乗り換えやすい。
評価とコストの考え方
公開ベンチマークの限界
モデルの発表時に示される点数は、比較の出発点にはなるが、業務での有用性を保証しない。学習データに評価内容が混入している可能性や、自社の文章とは傾向が違うという問題が常にある。
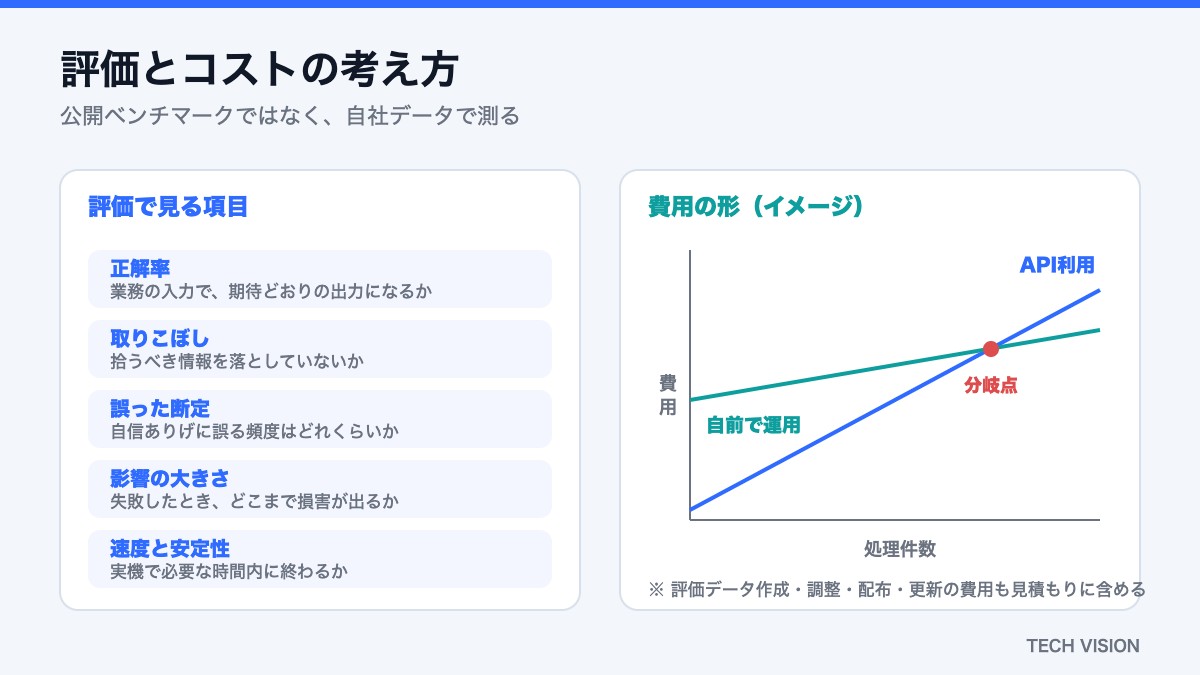
自社データで測る
現場の入力をそのまま使い、正解率、取りこぼし、誤った断定の頻度を測る。加えて、失敗したときの影響の大きさを分類しておくと、どこまで自動化してよいかの線引きがしやすい。
費用の比較軸
API利用は初期費用が小さく、量に応じて増える。自前で動かす場合は、機材と運用の費用が先に立つが、量が増えても急には膨らまない。処理件数の見通しと、どこまで内製できるかで分岐点が決まる。
見落とされがちな費用
評価データの作成、調整作業、端末への配布、更新運用、問題が起きたときの調査――これらは自前運用で必ず発生する。モデルの価格表に載らない費用を見積もりに含めることが、現実的な判断につながる。
関連する話題として、現実世界でAIを動かす潮流についてはロボティクスとフィジカルAIの時代へ、AIと外部システムの接続方法についてはMCP(Model Context Protocol)とは?もあわせて参考にしてほしい。
運用に必要な体制
SLMを自前で動かす場合、モデルを選ぶだけでは終わらない。継続して使うには、いくつかの役割が必要になる。
評価を担う人を決める
業務を理解している担当者が、評価データの作成と結果の判定を担う。技術者だけで評価すると、現場が求める品質とずれることが多い。少人数でも、業務側の目を入れる体制が要る。
失敗事例を集める仕組み
利用者が「おかしい」と感じた出力を、その場で記録できる導線を用意する。集まった事例は、調整や指示文の改善にそのまま使える。改善が回り始めると、精度は着実に上がっていく。
切り戻しと代替手段
モデルを更新したあとに品質が落ちることは珍しくない。前の版に戻せる仕組みと、AIを使わずに業務を回す手順の両方を残しておくと、導入のリスクを下げられる。
SLMの課題とこれから
品質の見極めが難しい
軽量モデルは、自然な文章を返しながら内容を誤ることがある。読みやすさと正しさは別物であり、人の確認をどこに挟むかを設計しないまま自動化するのは危うい。
端末側の制約
記憶容量、発熱、電池、機種ごとの性能差――端末で動かす場合の制約は多い。対応機種を絞るのか、クラウドへの切り替えを用意するのかを、あらかじめ決めておく必要がある。
ライセンスと利用条件
公開されているモデルにも、利用範囲や再配布の条件が設定されている。商用利用の可否、出力の扱い、派生モデルの公開義務などは、導入前に法務を含めて確認したい。
更新への追随
軽量モデルの世代交代は速い。半年前の選定が最適でなくなることは珍しくないため、差し替えやすい構成にしておくことが、長く使ううえでの保険になる。
これからの方向
端末の演算性能は着実に上がり、同じ規模でできることは増えている。一方で大規模モデルも進化を続けるため、両者の境界は今後も動き続ける。重要なのは流行を追うことではなく、自社の業務に必要な品質と制約を言語化しておくことだ。それさえあれば、選択肢が変わっても判断は揺らがない。
よくある質問
Q. SLMとLLMの境目は何パラメータですか?
A. 公式な定義はありません。実務では「端末や単一のGPUで動かせるか」という基準が使われます。数値の線引きよりも、動かす場所と求める品質から考えるほうが実用的です。
Q. 小さいモデルでも社内文書に答えられますか?
A. 検索や社内文書の参照と組み合わせれば可能です。モデル自体に知識を詰め込むより、必要な情報を渡す設計のほうが、更新のしやすさの面でも有利です。
Q. 微調整は必ず必要ですか?
A. 必要とは限りません。指示の書き方と参照データの工夫だけで要件を満たせることも多く、まずは調整なしで試すことをおすすめします。
Q. 量子化するとどれくらい品質が落ちますか?
A. 用途とモデルによって差が大きく、一概には言えません。評価データを用意し、量子化の前後で同じ基準で比較するのが唯一確実な方法です。
Q. どの程度の機材があれば動かせますか?
A. モデルの規模と量子化の度合いで変わります。数十億パラメータ規模を量子化すれば、一般的なPCやスマートフォンでも動作する例があります。実機での計測をおすすめします。
Q. ロボットに載せる場合の注意点は?
A. 応答時間の上限、通信断時の動作、異常時の停止条件を先に決めることです。モデルの判断を安全機構の代わりにしてはいけません。
Q. 大規模モデルと併用すると管理が複雑になりませんか?
A. 複雑にはなります。そのため、まずは一つの用途で軽量モデルに寄せ、効果が確認できてから振り分けの仕組みを導入する順序が現実的です。
Q. 自社でモデルを学習させる必要はありますか?
A. ほとんどの場合、必要ありません。公開されているモデルを選び、指示の工夫と少量の調整で要件を満たす方が、費用も期間も現実的です。
Q. クラウドのAPIから乗り換える判断基準は?
A. 処理件数が多く内容が定型的であること、応答速度や機密保持の要件があること、この二つが揃えば検討の価値があります。少量かつ多様な処理なら、APIのままのほうが安く済みます。
まとめ:SLMは「必要十分」を設計する技術
SLMの価値は、性能競争の上位に立つことではない。必要な品質を見極め、それを最も軽い形で満たすことにある。
- SLMは、端末や小さなサーバーで動かせる規模の言語モデルを指す
- 費用、速度、プライバシー、オフライン、電力という運用上の制約が普及を後押ししている
- 蒸留・量子化・データの質の向上が、小型化を支えている
- 広い知識や複雑な推論は大規模モデルに任せ、役割を分担する
- 公開ベンチマークではなく、自社データでの評価が成否を分ける
AIを業務に組み込む局面では、「最も賢いモデル」より「その仕事に足りるモデル」を選ぶほうが、速く、安く、安定して回る。まずは一つの作業を選び、評価データを作り、軽量モデルで試してみてほしい。想像より多くの処理が、手元で十分にこなせるはずだ。
※本記事の情報は2026年9月時点のものです。モデルの性能、対応端末、ライセンス条件、価格は変更される場合があります。導入の前に、各提供元の公式情報をご確認ください。