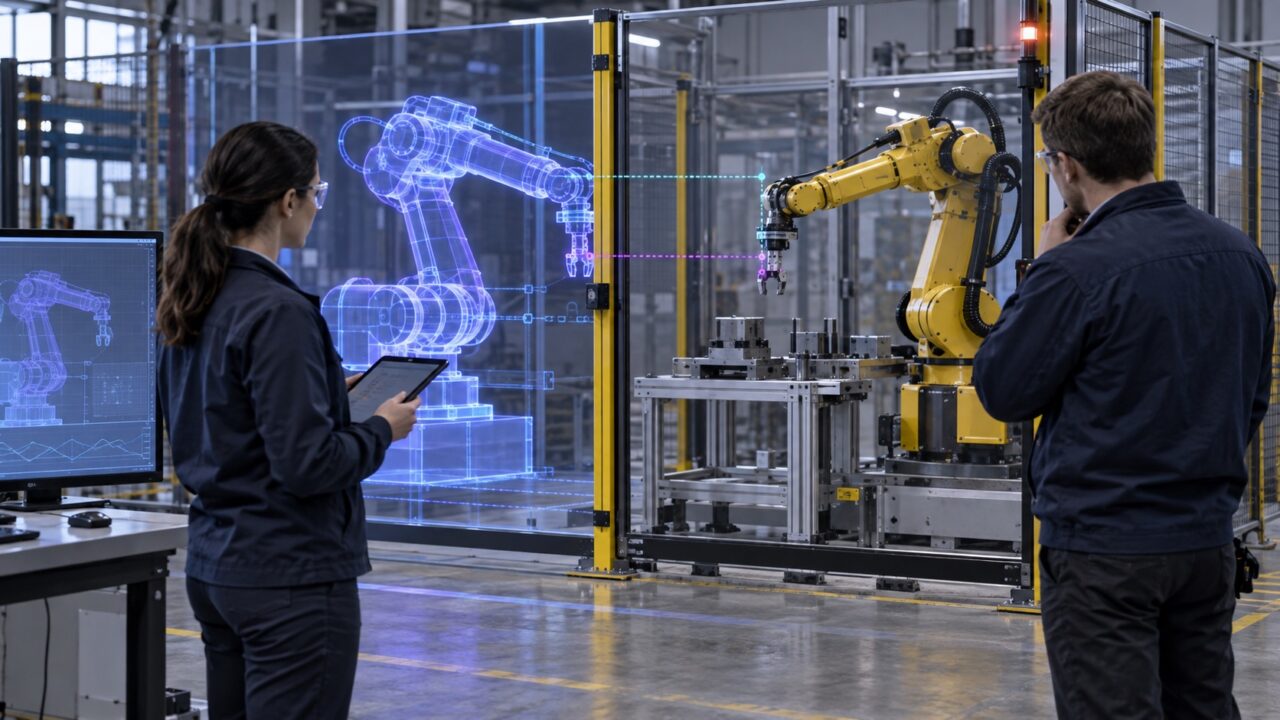
生成AIに文章や画像を作らせることは、すでに珍しくない。では、AIがカメラで工場を見て、物体の動きや人の行動を理解し、「ロボットが右へ動いたら次に何が起こるか」を予測したうえで、安全な行動を選べるようになったらどうだろう。
その実現に向けた重要技術が「ワールドモデル(世界モデル)」である。AIの内部に現実世界の簡略なシミュレーターを作り、まだ起きていない未来を予測させる。ロボットや自動運転車が、現実で危険な失敗を繰り返す前に、仮想環境で経験を積むための土台になる。
2026年5月、NVIDIAはワールドモデル、視覚推論、マルチモーダル生成、行動予測を一つの仕組みに統合した「NVIDIA Cosmos 3」を発表した。NVIDIAはこれを、フィジカルAI向けのオープンなワールド基盤モデル群と位置づけている。テキスト、画像、動画、環境音、ロボットの行動をまたいで扱い、世界の理解からシミュレーション、行動生成までをつなぐ構想だ。
ただし、Cosmos 3を「入れればロボットがすぐ万能になる」と考えるのは早い。現実とシミュレーションの差、学習データの偏り、安全評価、計算資源、現場ごとの追加学習など、実装には多くの課題が残る。
本稿では、NVIDIA Cosmos 3とは何かを出発点に、ワールドモデルの仕組み、生成AIやVLAとの違い、ロボット・自動運転・工場での使い方、企業が導入時に確認すべき点までを、2026年9月時点の公開情報に基づいて整理する。
この記事の要点
- NVIDIA Cosmos 3は、物理世界の理解、未来予測、映像生成、行動生成を統合したフィジカルAI向けのワールド基盤モデル群である
- ロボット開発では、実機だけで集めにくい危険・希少な場面を合成し、学習と評価に使えることが大きな価値になる
- VLAが主に「見て、指示を理解し、行動を出す」モデルなら、ワールドモデルは「その行動の先に何が起こるか」を予測する役割を担う
- 生成した映像が自然に見えても、物理法則や因果関係が正しいとは限らない。実機試験と安全制御は省略できない
- 日本企業の強みは、モデルの規模だけで競うことではなく、製造現場のデータ、機械設計、安全、保守を一体化することにある
NVIDIA Cosmos 3とは何か
NVIDIA Cosmos 3は、ロボット、自動運転、スマートインフラなど、現実空間で動くAIを開発するためのワールド基盤モデル(World Foundation Model)のファミリーである。
従来のAI開発では、目的ごとに異なるモデルを組み合わせることが多かった。映像を説明する視覚言語モデル、未来の動画を作る動画生成モデル、ロボットの動作を出す制御モデル、学習用データを作るシミュレーターが、それぞれ別の仕組みとして存在していた。
Cosmos 3が目指すのは、これらの境界を薄くすることだ。NVIDIAの公式発表では、テキスト、画像、動画、環境音、行動系列を一つのアーキテクチャで扱い、次のような用途に対応すると説明されている。
- 映像や画像の内容を理解し、物体の関係や動きを推論する
- 現在の状態から未来の映像や世界の状態を生成する
- 特定の行動を取った場合に起きる変化を予測する
- ロボットの学習用に、現実に近い合成データを作る
- 目的を達成するための行動候補や軌道を生成する
2025年に登場した初期のCosmosは、Predict、Transfer、Reasonなど目的別のモデルを中心に構成されていた。Cosmos 3では「理解するモデル」と「生成するモデル」の連携を深め、物理世界について考え、予測し、行動する流れを一つのファミリーで扱う方向へ進んだ。
重要なのは、Cosmos 3が完成品のロボットではないことだ。ChatGPTのように一般利用者が会話画面を開いて使う単体サービスでもない。ロボットメーカー、研究機関、製造業、自動運転開発企業などが、自社のデータと機体、シミュレーター、安全システムを組み合わせて使う開発基盤である。
そもそもワールドモデルとは
ワールドモデルとは、AIが観測した情報から、世界の状態と変化の規則を内部に学び、「次に何が起こるか」「この行動をしたらどう変わるか」を予測するモデルの総称である。分野によって定義や範囲は異なり、単一の規格があるわけではない。
人は日常生活で、小さな世界モデルを無意識に使っている。テーブルの端にコップを置けば落ちるかもしれない。濡れた床で急に向きを変えれば滑る。狭い通路で人とすれ違うときは、相手の進行方向を予測して少し避ける。このように、現実で試す前に頭の中で結果を想像し、行動を選んでいる。
AIのワールドモデルも発想は近い。現在の観測を圧縮した「状態」として捉え、行動を条件に次の状態を予測する。予測を一度で終わらせず、複数の行動候補について繰り返せば、目的に近づき、危険が少ない行動を選べる。
2018年にDavid Ha氏とJürgen Schmidhuber氏が発表した論文「World Models」では、環境の圧縮表現と時間変化を学ぶモデルを使い、エージェントをモデル内部の“夢”のような仮想環境で訓練できることが示された。今日の大規模なワールド基盤モデルは、同じ発想を動画、3D、音、言語、ロボットの動作へ広げたものと捉えられる。
ワールドモデルに必要な3つの能力
MetaはV-JEPA 2の説明で、ワールドモデルに重要な能力を「理解」「予測」「計画」の三つに整理している。
- 理解:映像内の物体、動作、位置関係、時間的な変化を把握する
- 予測:世界が自然に変化した場合と、AIが行動した場合の次の状態を推定する
- 計画:複数の予測結果を比較し、目標へ到達する行動の順序を選ぶ
単にきれいな未来映像を生成できるだけでは、ロボットを安全に動かすワールドモデルとしては不十分だ。物体が途中で消えないか、重力や衝突が一貫しているか、行動と結果の因果関係が保たれているか、予測の不確実性を示せるかまでが問われる。
生成AI・動画生成AIとの違い
大規模言語モデルは、文脈に続く言葉を高い精度で予測する。画像・動画生成AIは、入力条件に合う画素やフレームの系列を作る。これに対してワールドモデルは、生成能力を使う場合でも、エージェントの行動と環境の変化を結びつけ、意思決定に役立つ未来を表すことが中心になる。
| 比較項目 | 大規模言語モデル | 動画生成AI | ワールドモデル |
|---|---|---|---|
| 主な入力 | テキスト | テキスト、画像、動画 | 映像、センサー、言語、行動 |
| 主な出力 | 文章、コード | 動画 | 次の状態、映像、評価、行動候補 |
| 得意なこと | 言語理解と生成 | 見た目の自然な映像生成 | 世界の変化予測と計画支援 |
| 重要な評価 | 正確さ、有用性、一貫性 | 画質、動き、指示への一致 | 物理整合性、因果、制御可能性、安全性 |
| 主な用途 | 対話、検索、文書作成 | 広告、映像制作 | ロボット、自動運転、シミュレーション |
境界は完全に分かれているわけではない。動画生成モデルが物理的な一貫性を高め、操作入力に応じて環境を変化させられるようになれば、ワールドモデルに近づく。逆に、ワールドモデルも人が結果を確認できるよう、未来を動画として生成することがある。
判断のポイントは「何を作れるか」だけではなく、「行動を変えたときの結果を比較し、意思決定に使えるか」である。
なぜロボットにワールドモデルが必要なのか
工場のロボットは長い間、決められた位置で決められた動作を正確に繰り返すことを得意としてきた。対象物の位置、照明、周囲の人の動線を整えれば、動作を事前に細かくプログラムできる。
しかし、家庭、物流倉庫、店舗、病院、屋外では条件が毎回変わる。箱の向きが少し違う。通路へ人が入る。透明な容器が反射する。床が濡れている。持ち上げた袋の中身が動く。すべての例外を人が先回りしてルール化することは難しい。
そこでロボットは、現在の映像を認識するだけでなく、動いた先を予測する必要がある。アームを伸ばしたら隣の物に当たらないか。箱を押したら倒れないか。人が進んでいる方向へ車輪を向けていないか。把持力を弱めたら物体が滑らないか。ワールドモデルは、実際に動く前に複数の可能性を内部で試すために使われる。
これは、「ロボティクスとフィジカルAIの時代へ」で取り上げた、AIがデジタル空間から現実世界へ出るための重要な一歩でもある。
Cosmos 3の中核——ReasonerとGenerator
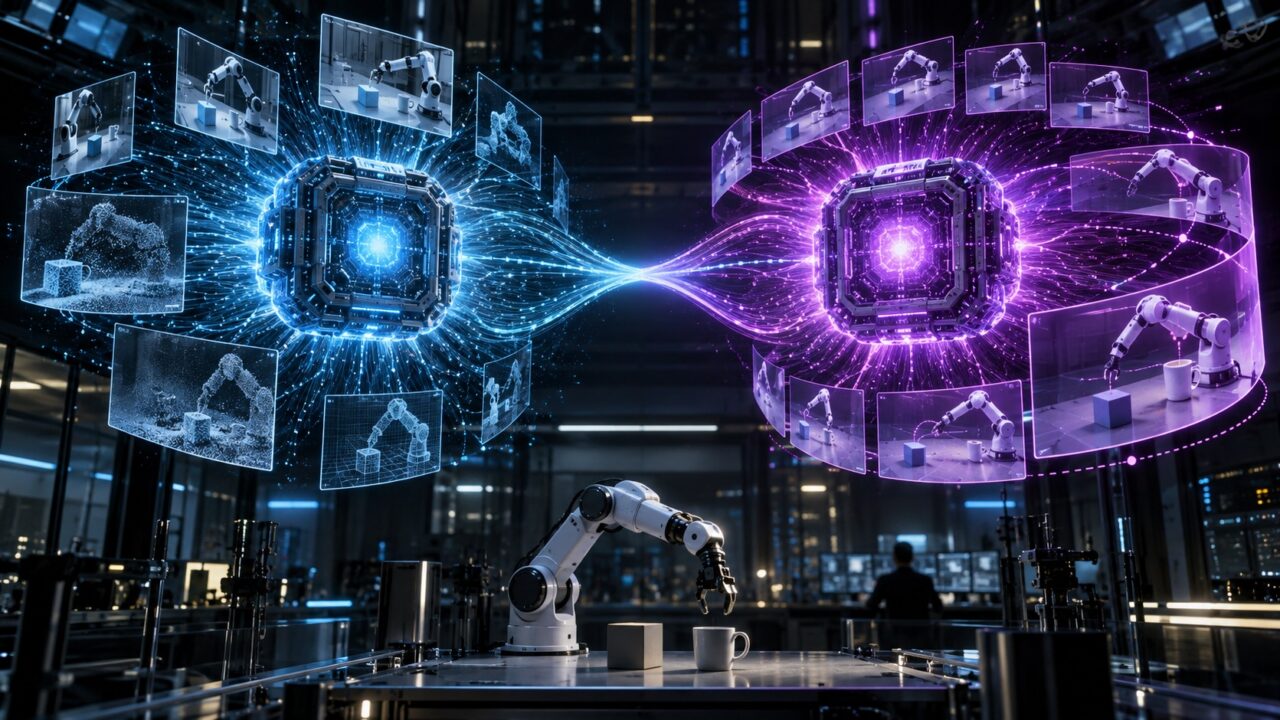
Cosmos 3の特徴を理解するには、二つの働きに分けると分かりやすい。
一つ目はReasoner(推論側)である。画像や動画を見て、何が起きているか、次に何が起こりそうか、どこに危険があるか、目標達成には何をすべきかを言語や内部表現で考える。
二つ目はGenerator(生成側)である。テキスト、映像、音、行動などを条件として、次の画像や動画、環境音、行動系列を生成する。ロボットがある動作を取った後の場面を映像化したり、学習用の別条件を作ったりする役割を担う。
NVIDIAが公開した説明では、Cosmos 3は推論用の自己回帰Transformerと、生成用のDiffusion Transformerを組み合わせたMixture-of-Transformers構成を採用している。すべてを一つの同じ処理で扱うのではなく、推論と生成の得意な仕組みを連携させる設計である。
この統合には実務上の意味がある。映像を作るモデルと映像を評価するモデルが完全に別なら、生成した場面が学習に適しているか、物理的に不自然でないかを別工程で確認しなければならない。理解、生成、行動を近い表現でつなげられれば、データ作成から評価、方策学習までの往復を短くできる可能性がある。
Super・Nano・Edgeの違い
Cosmos 3は用途と計算資源に応じたモデル群として公開されている。
- Cosmos 3 Super:高い生成品質や物理精度を重視する大規模モデル。データセンターでの合成データ生成や教師モデル、追加学習向け
- Cosmos 3 Nano:品質と速度のバランスを取ったモデル。ワークステーションやデータセンターでの推論、ロボット方策の研究開発向け
- Cosmos 3 Edge:ロボットやエッジ機器に近い場所でのリアルタイム処理を狙う小型モデル。対応機能と公開状況は更新されるため、導入時に公式リポジトリで確認する必要がある
モデル名が小さいから、すぐ一般的なノートパソコンで動くという意味ではない。公開リポジトリに示された推奨環境は、高性能なデータセンターGPU、ワークステーションGPU、Jetson系のエッジ機器などである。導入時は、モデルの公開有無、必要メモリー、対応する入出力、ライセンス、推論速度をバージョンごとに確認する必要がある。
Cosmos 3を使ったロボット開発の流れ
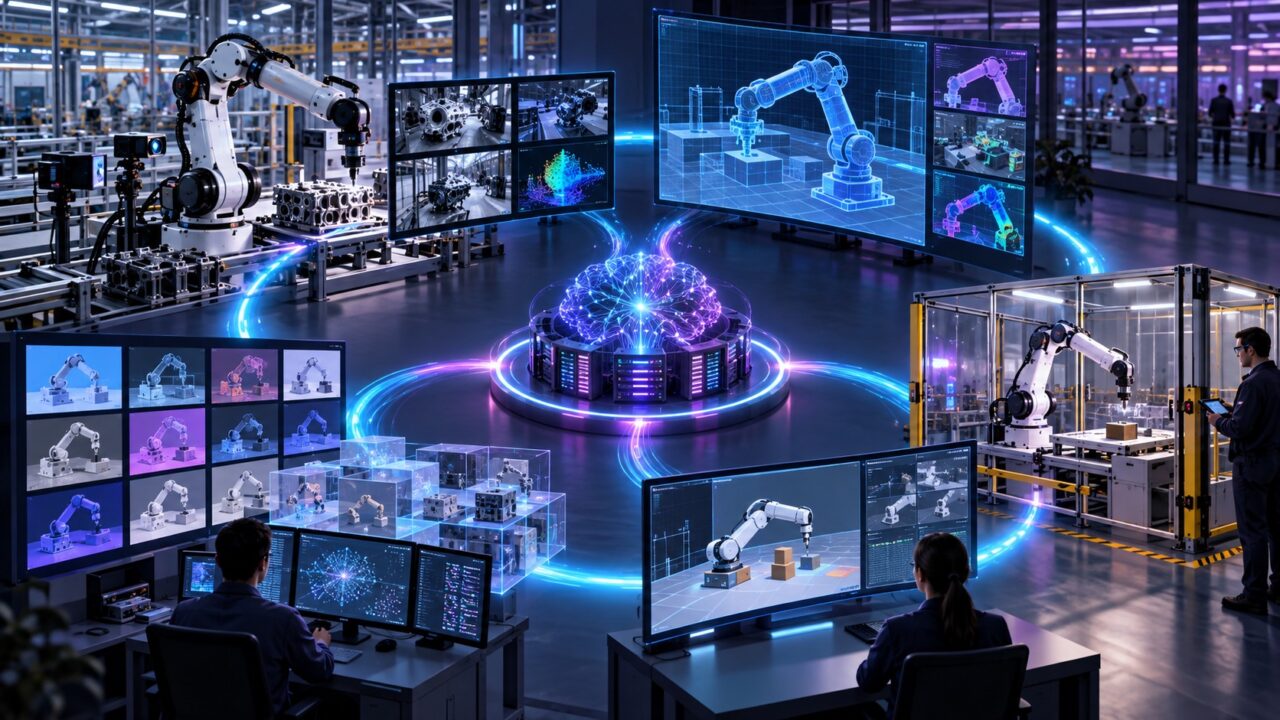
Cosmos 3は、単独で現場を自動化する魔法の箱ではない。一般的な開発は次のような循環になる。
1. 現場のデータを集める
カメラ映像、深度、ロボットの関節状態、把持力、移動速度、作業結果などを記録する。成功例だけでなく、失敗、停止、人の介入、環境変化も重要なデータになる。
2. データを整理する
重複や低品質な映像を除き、個人情報や機密情報を管理し、動作と結果を対応させる。大量に集めるだけでは学習品質は上がらない。どの条件が不足しているかを把握する工程が必要だ。
3. 不足する場面を生成する
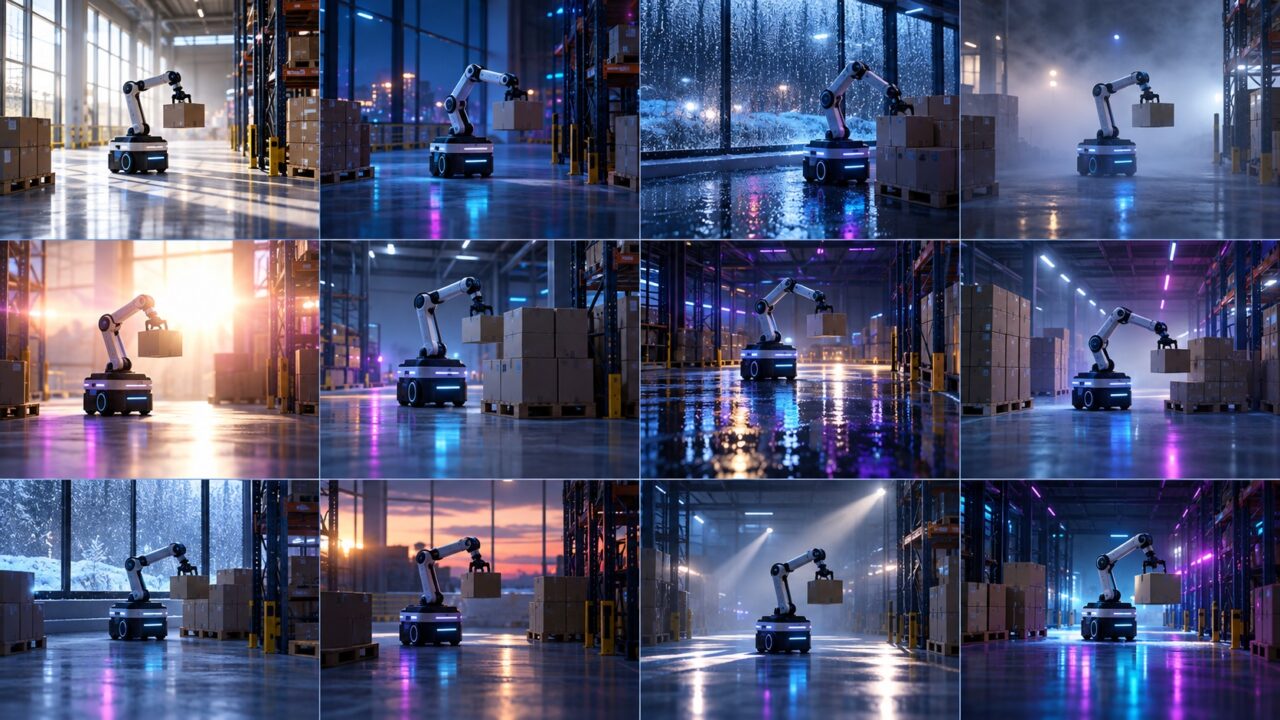
夜間、逆光、雨、煙、通路への飛び出し、荷物の崩れなど、現実では集めにくい条件を生成する。既存の3Dシミュレーションを現実に近い映像へ変換する使い方もある。
4. 方策や認識モデルを訓練する
実データと合成データを組み合わせ、物体認識、行動予測、ロボット方策などを追加学習する。合成データの比率や条件が偏ると、かえって性能が落ちるため検証が欠かせない。
5. 仮想環境で評価する
行動候補をシミュレーションし、衝突、転倒、停止距離、タスク達成率などを測る。安全上重要なケースは、結果の平均だけでなく、失敗の種類と最悪条件を見る。
6. 実機で段階的に確かめる
低速、軽い対象物、立入制限された環境から試験し、現実との差を記録する。そこで得た失敗データを再び学習とシミュレーションへ戻す。ワールドモデルの価値は一度の生成ではなく、この改善循環を速くする点にある。
活用例1:合成データで「経験不足」を補う
ロボットAIの大きな課題は、質の高い動作データが足りないことだ。文章や画像はインターネット上に大量にあるが、ロボットのデータには、カメラ映像と関節角度、速度、力、成功・失敗の結果が対応していなければならない。機体が異なれば行動表現も変わる。
実機で一件ずつ集めると、時間、設備、人員が必要になる。危険な失敗を意図的に起こすことも難しい。そこで、少量の実データや3Dシミュレーションを基に、背景、照明、対象物、視点、動きを変えた合成データを作る。
例えば倉庫の搬送ロボットなら、棚の配置、床の反射、箱の高さ、人の服装、フォークリフトの動線を変えた映像を生成できる。検査AIなら、傷、へこみ、汚れ、欠品の見え方を増やせる。自動運転なら、雨や霧、夕暮れ、工事規制、落下物などの条件を補える。
ただし、合成データは現実の代用品ではなく、現実データを補う道具である。生成モデルが苦手な物理現象やセンサー特性があると、その誤差まで学習される。実データだけの評価セットを残し、合成データを加えたことで現場性能が本当に上がったかを分けて測る必要がある。
活用例2:危険・希少な場面を先に試す
事故につながる条件ほど、実世界では十分に収集できない。人の飛び出し、荷崩れ、機械の故障、センサーの遮蔽、突然の停電などは頻度が低い一方、一度の失敗が大きな損害になる。
ワールドモデルは、こうしたエッジケースを条件付きで生成し、認識や制御の弱点を探すために使える。あるシナリオで失敗したら、速度、照明、対象物の位置などを少しずつ変えた周辺ケースを作り、どの境界で安全性が崩れるかを調べる。
ここで注意したいのは、生成した「それらしい危険映像」が、現実の事故確率を正しく表しているとは限らないことだ。安全評価には、実測データ、物理シミュレーション、規格に基づく試験、専門家の分析を組み合わせなければならない。ワールドモデルだけで安全を証明することはできない。
活用例3:ロボットが動く前に結果を予測する
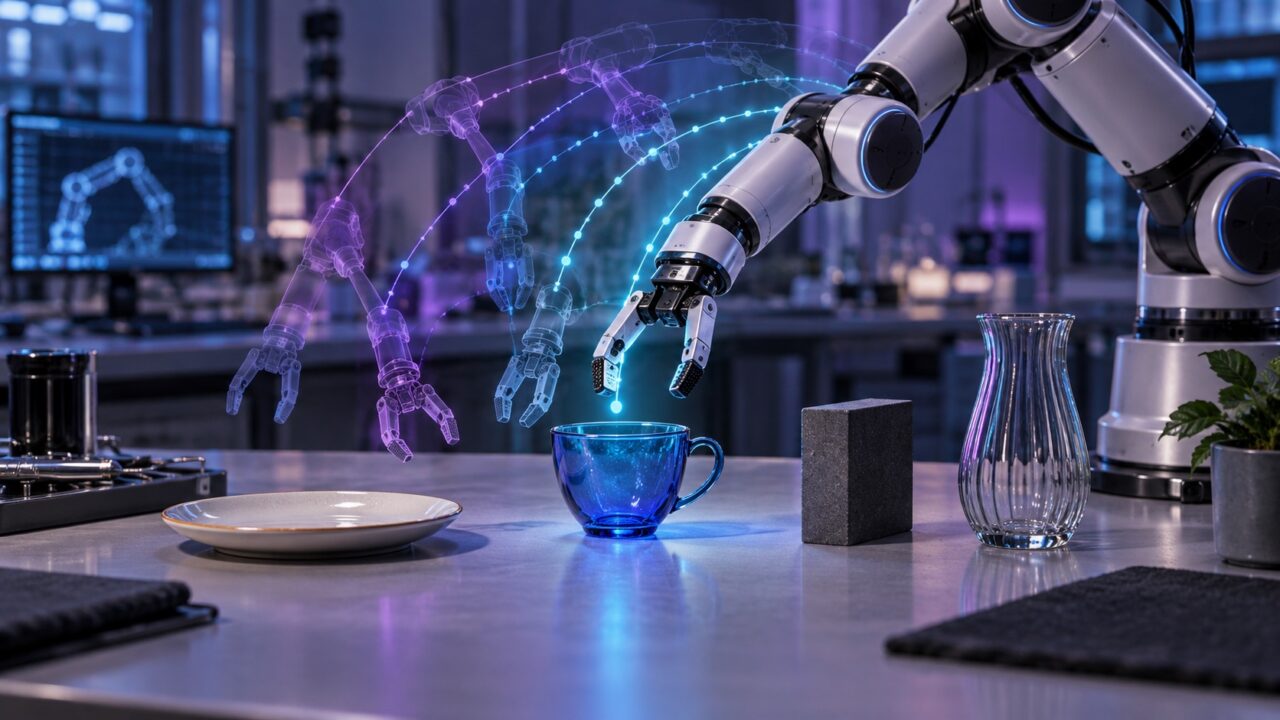
ロボットへ「青いカップをトレーへ置いて」と指示したとする。カメラでカップを認識するだけでは作業は終わらない。どの角度から手を伸ばすか、隣の皿を避けられるか、どの強さでつかむか、途中で滑ったらどう回復するかを決める必要がある。
ワールドモデルを使う計画では、候補となる動作を内部で複数試し、各動作後の状態を予測する。目標画像や成功条件に最も近い候補を選び、少し動いたら再び観測して計画を更新する。現実のずれを毎回取り込みながら進めるモデル予測制御に近い考え方だ。
MetaのV-JEPA 2は、現在と目標の映像表現を比較し、候補行動の結果を予測することで、未学習の物体を使った到達・把持・配置を試している。Metaの報告では、限定された研究条件において、視覚的な中間目標を使う新規物体のピック&プレースで65〜80%の成功率を示した。一方、人間のような長時間の家事を安定して完了できる水準とはまだ言えない。
この点は、「家庭用ロボットはなぜ普及しない?」で見た、工程が長くなるほど失敗が積み重なる問題にも直結する。ワールドモデルは失敗をゼロにするのではなく、失敗を事前に予測し、途中で計画を修正するための道具になる。
Cosmos 3・VLA・デジタルツインは何が違うのか
似た用語が増えたため、役割を分けて理解したい。
VLAは「見て、指示を理解し、行動へ変える」
VLA(Vision-Language-Action)は、カメラ映像と自然言語の指示を入力し、ロボットの動作を出力するモデルである。「赤い箱を右の棚へ置いて」という指示を、アームの移動やグリッパーの開閉へつなぐ。
ワールドモデルは「動いた後の世界を予測する」
ワールドモデルは、現在の状態と行動から次の状態を予測する。VLAが行動候補を作り、ワールドモデルが結果を見積もる構成もあれば、一つのモデルが両方の役割を持つ構成もある。Cosmos 3は行動生成まで統合するため、従来の分類の境界をまたぐ。
デジタルツインは「特定の現場を再現する」
デジタルツインは、工場、倉庫、車両、都市など、特定の現実対象をデジタル空間に対応付ける仕組みである。設備の寸法や稼働状態を高い精度で再現し、監視やシミュレーションに使う。
ワールドモデルは、大量データから変化の規則を学び、未知の状態を予測・生成する。デジタルツインへワールドモデルを組み込めば、固定された再現環境に、より多様な人の動きや外観、異常、未来予測を加えられる。ただし、生成結果が設計値や物理計算を置き換えるわけではない。
Genie 3やV-JEPA 2との違い
2025年以降、複数の企業が異なる方向からワールドモデルを発表している。
Google DeepMindのGenie 3は、テキストから操作可能な環境を生成する汎用ワールドモデルである。公式発表では、720p、24フレーム毎秒で、数分間の一貫性を保ちながらリアルタイムに移動できる世界を生成するとされる。エージェントの訓練環境、ゲーム、教育、シミュレーションへの可能性が大きい。
MetaのV-JEPA 2は、画素を細部まで生成するより、動画の重要な抽象表現を予測することに重点を置く。100万時間を超える動画などで自己教師あり事前学習し、その後、比較的少量のロボット動画を使って行動条件付きの予測へ適応させている。
NVIDIAのCosmos 3は、映像理解、物理推論、マルチモーダル生成、ロボット行動、開発用データ処理をフィジカルAIのプラットフォームとしてまとめる色合いが強い。モデルだけでなく、GPU、シミュレーション、ロボティクス開発環境と組み合わせた産業実装を狙っている。
優劣を一列に並べるより、何を入力し、何を出力し、どの機体や開発工程で使えるかを見るべきだ。研究デモの映像品質だけでは、実機の成功率、遅延、コスト、安全性は分からない。
どの産業で使われるのか
物流・倉庫
箱の把持、仕分け、パレット積み、搬送、人との動線共有に使える。商品の形や配置が頻繁に変わる現場では、例外データを生成し、ロボットの適応範囲を広げる価値が大きい。
製造業
部品供給、組み立て、外観検査、設備監視、安全教育に使える。ライン変更時の事前検証や、不良データが少ない検査工程への合成データ活用が考えられる。
自動運転・移動ロボット
雨、霧、逆光、夜間、工事、急な飛び出しなど、実走行だけで網羅しにくい条件の学習と評価に使える。車両の操作を条件として、その後の周囲環境を予測する能力が重要になる。
店舗・病院・介護
人が多い場所での案内、運搬、清掃、見守りを支援できる可能性がある。一方で、映像には顔、健康状態、生活行動が含まれ得るため、データ最小化、端末内処理、アクセス管理、保存期間の設計が不可欠だ。
ゲーム・映像・教育
操作可能な世界を自動生成し、訓練や体験型コンテンツへ使える。ただし、Cosmos 3の主眼は一般的な娯楽用動画生成だけでなく、物理世界で行動するAIの学習と評価にある。
Cosmos 3の強み
1. 理解・生成・行動を一つの開発基盤へ近づけた
別々のモデルを接続する手間を減らし、映像の理解から未来生成、行動方策までを共通のデータ表現で扱える可能性がある。工程間の変換が減れば、追加学習と評価の周期を短くできる。
2. 現実で集めにくいデータを増やせる
危険、希少、季節限定、設備故障などの条件を生成し、認識や制御の弱点を探せる。人が一件ずつ3D環境を作る場合より、条件の組み合わせを広げやすい。
3. 大きさと用途の異なるモデルを選べる
高品質なデータ生成は大規模モデル、素早い推論やロボット制御は小型モデルという分担ができる。大規模モデルを教師として小型モデルへ知識を移す設計にも向く。
4. 公開モデルと開発資産がある
NVIDIAはモデル、コード、評価手順、データ処理ツールなどを公開している。ただし、「オープン」という言葉だけで自由利用と判断せず、モデルごとのライセンス、商用条件、依存ソフトウェアを確認する必要がある。
現在の限界と見落とせないリスク
見た目の自然さと物理的な正しさは別である
人が見て自然な動画でも、重さ、摩擦、衝突、剛性、液体、機械の制約が正しいとは限らない。わずかな誤差でも、ロボットアームの接触や車両の停止距離では重大になる。
長い時間の予測ほど誤差が積み重なる
一秒後の動きを当てられても、数分後の複雑な結果は難しい。作業工程が長く、複数の人や物体が関わるほど、最初の小さな誤差が広がる。長期計画では途中の再観測と再計画が必要だ。
シミュレーションと現実の差は消えない
カメラのノイズ、モーターの摩耗、床の微細な凹凸、ネットワーク遅延、人の予測しにくい動きなど、現場にしかない条件がある。合成データで好成績でも、実機試験を通らなければ導入判断はできない。
データの権利とプライバシーが問題になる
工場映像には製造ノウハウが、店舗や家庭の映像には個人情報が含まれる。学習データの利用目的、保存場所、再利用範囲、委託先、削除方法を決めなければならない。生成データにも元データの特徴が残る可能性を考慮する。
計算コストと運用コストが大きい
大規模な動画モデルは、学習だけでなく推論、データ保存、評価にも費用がかかる。モデルの利用料だけでなく、GPU、ネットワーク、ストレージ、データ整備、実機試験、監視、再学習を含む総保有コストを見る必要がある。
メーカー発表と第三者評価を分ける必要がある
Cosmos 3の性能値や開発期間短縮は、まずNVIDIAが公開した条件での結果である。比較モデル、評価データ、解像度、ハードウェア、成功条件が変われば結果も変わる。自社の代表タスクと失敗条件を使った評価を行い、再現性を確認すべきだ。
日本企業にとっての機会
ワールドモデルの競争は、モデルのパラメーター数だけでは決まらない。現実の機械を安全に動かし、故障時に直し、長く運用するには、機械設計、制御、現場改善、品質保証、保守網が必要になる。
日本の製造業、物流、建設、介護には、長年蓄積した作業手順、異常対応、熟練者の判断がある。これらは文章だけでなく、視線、手順、力加減、音、振動、作業前後の状態として存在する。適切な権利管理の下でデータ化できれば、汎用モデルを特定現場へ適応させる貴重な資産になる。
一方で、各社が小規模な実証を繰り返し、データ形式も安全指標も共有されなければ、学習資産が分散する。競争領域は独自工程として守りながら、非常停止、ログ、機体状態、データ記述、評価方法などの共通部分を標準化することが重要だ。
勝ち筋は、海外の大規模モデルをそのまま追うことだけではない。汎用ワールドモデルを土台に、日本の現場データ、小型で精密な機体、安全設計、保守サービスを組み合わせ、「何年も安定して使える仕組み」にすることだろう。「ロボティクス大国・日本の逆襲」で論じたように、実装力そのものが競争力になる。
導入を検討する企業が確認すべき10項目
- 対象タスク:何を成功とし、どの失敗を減らしたいのか
- 入力データ:RGB映像、深度、音、力覚、関節状態のどれを使うのか
- 行動出力:どの機体の、どの制御周期と座標系に対応するのか
- 実機評価:未学習の物体、照明、配置、人の動きで試したか
- 安全層:AIの出力から独立した速度制限、停止、干渉検知があるか
- 遅延:認識、通信、推論、制御を合わせて必要時間内に収まるか
- データ権利:撮影対象、従業員、顧客、取引先との権利関係は明確か
- コスト:GPU、保存、学習、評価、保守を含む年間費用はいくらか
- ライセンス:商用利用、改変、再配布、生成データの扱いを確認したか
- 停止後の運用:クラウドやモデル更新が止まっても安全に停止・復旧できるか
PoCでは「デモが成功したか」だけでなく、100回、1,000回の試行でどのように失敗するかを記録したい。平均成功率が同じでも、安全に停止する失敗と、人や設備へ衝突する失敗では意味がまったく違う。
2026年から2030年までに起こりそうな変化
以下は確定した未来ではなく、現在の技術と産業動向から考えられるシナリオである。
合成データが「量」から「弱点を狙う質」へ変わる
無作為に映像を増やすより、モデルが失敗しやすい境界条件を自動で見つけ、その周辺のデータを生成する使い方が広がる。生成、評価、再学習が一つの循環として自動化される。
大規模モデルと現場モデルの分業が進む
データセンターの大規模モデルが多様な場面を理解・生成し、現場では小型モデルが低遅延で制御する。大規模モデルは教師や検証役、小型モデルは実行役という構成が現実的になる。
VLAとワールドモデルの境界が薄くなる
行動を直接出すVLAに未来予測を組み込み、ワールドモデルに行動生成を組み込む動きが進む。名称よりも、閉ループで再観測し、失敗を検知し、安全に中止できるかが重要になる。
評価基準が動画品質から実機の成果へ移る
映像の見栄えだけでなく、未学習環境での成功率、介入回数、停止の適切さ、エネルギー、故障、復旧時間が重視される。ベンチマークと現場KPIの間をつなぐ評価設計が競争力になる。
ロボットは「考えてから動く」だけでなく「動きながら考え直す」
現実は予測どおりに進まない。数秒先を一度決めて実行し切るのではなく、短い周期で観測し、予測し、動き、結果を確認して計画を更新する。ワールドモデルの役割は未来を完璧に当てることより、ずれに気づいて修正することへ広がる。
よくある質問
NVIDIA Cosmos 3は無料で使えますか
公開モデルやコードは利用できるが、すべてが無条件に無料という意味ではない。モデルとソフトウェアごとのライセンス、利用するクラウドやGPUの費用、保存・学習・運用費を確認する必要がある。
一般のパソコンで動かせますか
主要モデルは大きく、高性能GPUを前提とする。小型モデルや量子化、クラウド利用という選択肢はあるが、一般的なノートパソコンでCosmos 3の全機能を快適に動かせるとは考えないほうがよい。公式リポジトリの最新版で推奨環境を確認したい。
Cosmos 3があればロボットのプログラミングは不要になりますか
不要にはならない。機体の制御、センサー接続、安全制限、タスク定義、データ収集、監視、復旧処理が必要である。役割は、作業ごとにすべてを固定ルールで書く負担を減らし、未知の条件への適応範囲を広げることだ。
ワールドモデルはLLMを置き換えますか
置き換えるというより補完する。LLMは言語による知識、指示理解、説明に強く、ワールドモデルは空間・時間・行動結果の予測に重点がある。ロボットでは両者を組み合わせる構成が増えると考えられる。
生成した合成データだけで実機を訓練できますか
限定された条件では可能な研究もあるが、一般的な現場導入では実データによる調整と評価が必要である。センサー特性、摩擦、摩耗、人の行動など、生成環境が再現しきれない差が残るためだ。
家庭用ロボットはすぐ賢くなりますか
ワールドモデルは進歩を後押しするが、価格、安全、電池、騒音、修理、プライバシー、長期信頼性は別の課題として残る。技術デモが家庭で毎日使える製品になるまでには、機械とサービスの両方を成熟させる必要がある。
まとめ——Cosmos 3の本当の価値は「失敗する前に試せること」
NVIDIA Cosmos 3は、映像を美しく生成するだけのAIではない。現実世界を観測し、物体や動きを理解し、行動後の未来を生成し、ロボットの学習と計画へつなげるワールド基盤モデルである。
最大の価値は、ロボットが現実で失敗する前に、仮想の世界で多くの条件を試せることにある。危険で集めにくいデータを補い、弱点を見つけ、行動候補を比較し、実機で得た失敗を再び学習へ戻す。この循環が速くなれば、フィジカルAIの開発期間とコストを下げられる可能性がある。
一方、生成された世界は現実そのものではない。映像が自然でも、物理的に正確とは限らず、安全を保証するものでもない。導入の判断では、モデルの派手なデモより、未学習条件での実機成功率、失敗時の停止、遅延、データ権利、総保有コストを確認すべきだ。
AIが言葉の世界から物理世界へ進むほど、評価の基準は「何を言えたか」から「何を安全にやり遂げたか」へ変わる。Cosmos 3は、その転換を象徴する技術である。だが、最終的に信頼されるのは、最も大きなモデルではなく、現場で失敗を認識し、人と機械を守りながら仕事を終えられる仕組みだろう。
参考資料
- NVIDIA「Cosmos 3」公式発表(2026年5月31日)
- NVIDIA Cosmos 公式GitHubリポジトリ
- Google DeepMind「Genie 3」公式解説
- Meta「V-JEPA 2」公式解説
- David Ha / Jürgen Schmidhuber「World Models」