「生成AIに社内の規程やマニュアルについて聞いても、それらしい嘘を返してくる」。業務でAIを使い始めた組織の多くが、最初にぶつかる壁である。モデルは学習した時点までの一般知識しか持っておらず、社内の文書や昨日更新された情報は知らない。知らないことを聞かれても、もっともらしい文章を組み立ててしまう。
この問題に対する最も実践的な答えがRAG(Retrieval-Augmented Generation:検索拡張生成)だ。質問に関係する文書をまず検索し、その内容を根拠としてAIに渡してから回答させる。モデルを作り直さなくても、手元の文書にもとづいて答えるAIを作れる。
一方で、RAGは「文書を入れれば賢くなる」魔法ではない。文書の切り方、検索の方法、指示文の書き方、評価のやり方によって、精度は大きく変わる。作ってはみたものの、「肝心なところで答えが外れる」「どの文書を参照したのか分からない」という状態で止まっている例も少なくない。
本稿では、RAGの仕組みから、ファインチューニングとの違い、作り方の7ステップ、精度を上げるコツ、評価の方法、ローカルLLMでの構成例、エージェント型RAGなど最新の動向までを、初めての人にも分かるように順を追って解説する。2026年9月時点の情報にもとづいている。
この記事の要点
- RAGとは、質問に関係する文書を検索し、その内容を根拠にAIが回答する仕組みのこと
- モデルを再学習せずに、社内文書や最新情報にもとづく回答ができ、根拠も示せる
- 処理は「文書を検索できる形にする準備」と「検索して答える本番」の2段階に分かれる
- 知識を足すならRAG、話し方や出力形式を変えるならファインチューニングが基本の使い分け
- 精度を左右するのは、モデルの性能よりも文書の整備・分割・検索の設計であることが多い
- キーワード検索とベクトル検索を組み合わせ、再ランキングを加えると検索の取りこぼしが減る
- 評価用の質問と正解を用意し、検索と回答を分けて測ることが改善の近道
RAG(検索拡張生成)とは?仕組みをわかりやすく解説
 RAGとは?通常の生成AIとRAGの違い(調べてから答える仕組み)
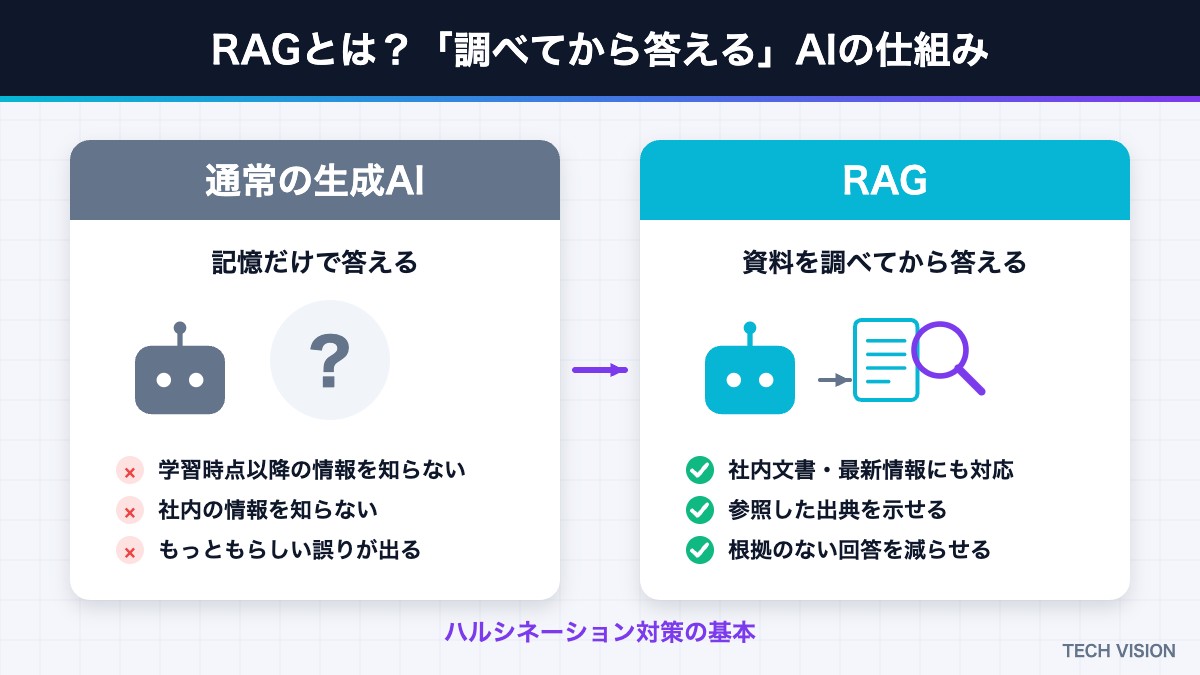
RAGとは、大規模言語モデル(LLM)が回答を生成する前に、外部の文書やデータベースから関連する情報を検索し、その情報を入力に加えて回答させる手法である。名前のとおり「検索(Retrieval)」で「生成(Generation)」を「拡張(Augmented)」する。
身近なたとえでいえば、「記憶だけで答える人」を「資料を調べてから答える人」に変える仕組みだ。試験でいえば、持ち込み可の試験に近い。モデルの頭の中にない情報でも、手元の資料から該当箇所を探し出せれば、正確に答えられる。
なぜRAGが必要なのか
LLMには構造的な弱点が三つある。一つ目は、学習した時点以降の情報を知らないこと。二つ目は、社内規程や顧客データのような非公開の情報を知らないこと。三つ目は、知らないことでも自然な文章を作れてしまうため、事実と異なる内容(ハルシネーション)を生成することだ。
RAGはこの三つにまとめて効く。検索対象の文書を更新すれば最新の情報で答えられ、社内文書を検索対象にすれば社内の事情に沿って答えられる。そして「渡した資料に書かれている範囲で答える」よう指示することで、根拠のない回答を減らせる。参照した文書を回答と一緒に示せるため、利用者が自分で確認できる点も業務では大きい。
RAGの仕組み:「準備」と「本番」の2段階
 RAGの処理の流れ(インデックス作成と検索・回答生成の2段階)
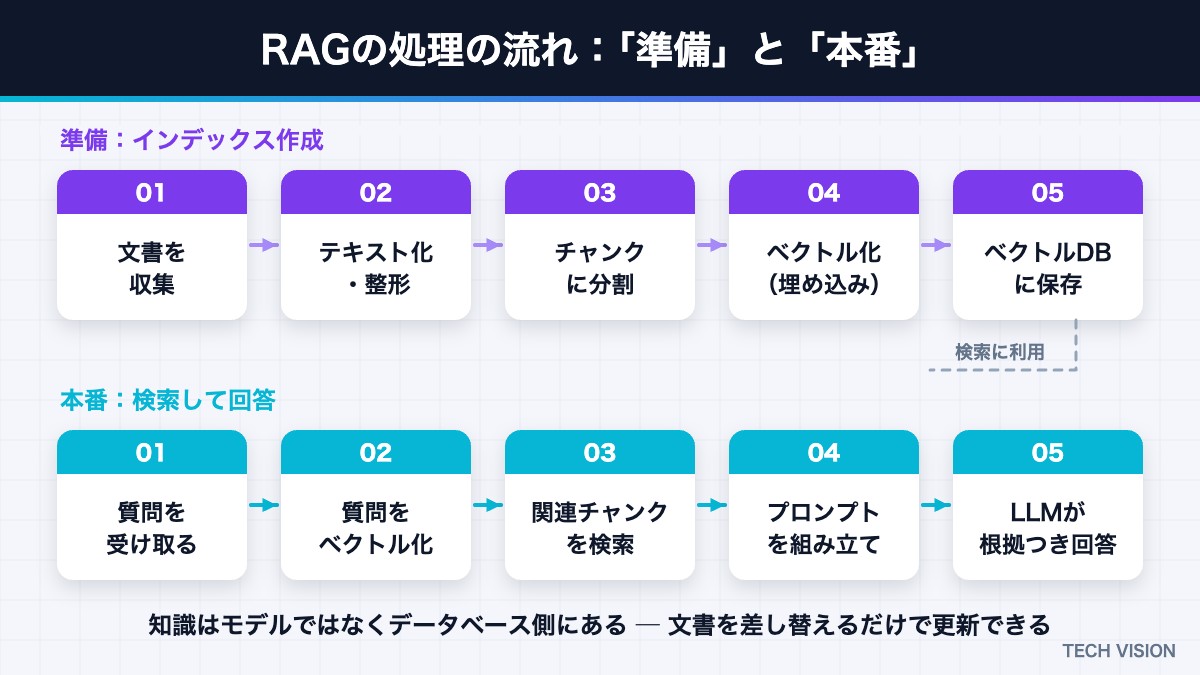
RAGの処理は、あらかじめ文書を検索できる形にしておくインデックス作成(準備)と、質問を受けて回答する検索・生成(本番)の二つに分けて考えると理解しやすい。
準備:文書を検索できる形にする
- 文書の収集:PDF、Word、社内Wiki、FAQ、チャットの記録などを集める
- テキスト化と整形:表や見出しを崩さずに文字データへ変換し、不要な部分を除く
- チャンク分割:長い文書を、数百〜千文字程度の意味のまとまりに切り分ける
- 埋め込み(ベクトル化):各チャンクを、意味を表す数値の並び(ベクトル)に変換する
- 保存:ベクトルと元の文章、出典情報をベクトルデータベースに保存する
本番:検索してから答える
- 質問のベクトル化:利用者の質問も同じ方法でベクトルに変換する
- 検索:質問と意味が近いチャンクを、データベースから上位数件取り出す
- プロンプトの組み立て:「以下の資料にもとづいて答えよ」という指示と、検索したチャンクと、質問をまとめる
- 生成:LLMが資料を読んで回答を作り、参照した出典を添えて返す
ポイントは、LLM自体は何も学習していないことだ。知識はデータベース側にあり、モデルは毎回渡された資料を読んで答えているにすぎない。だからこそ、文書を差し替えるだけで知識を更新できる。
RAGとファインチューニング・長文コンテキストの違い
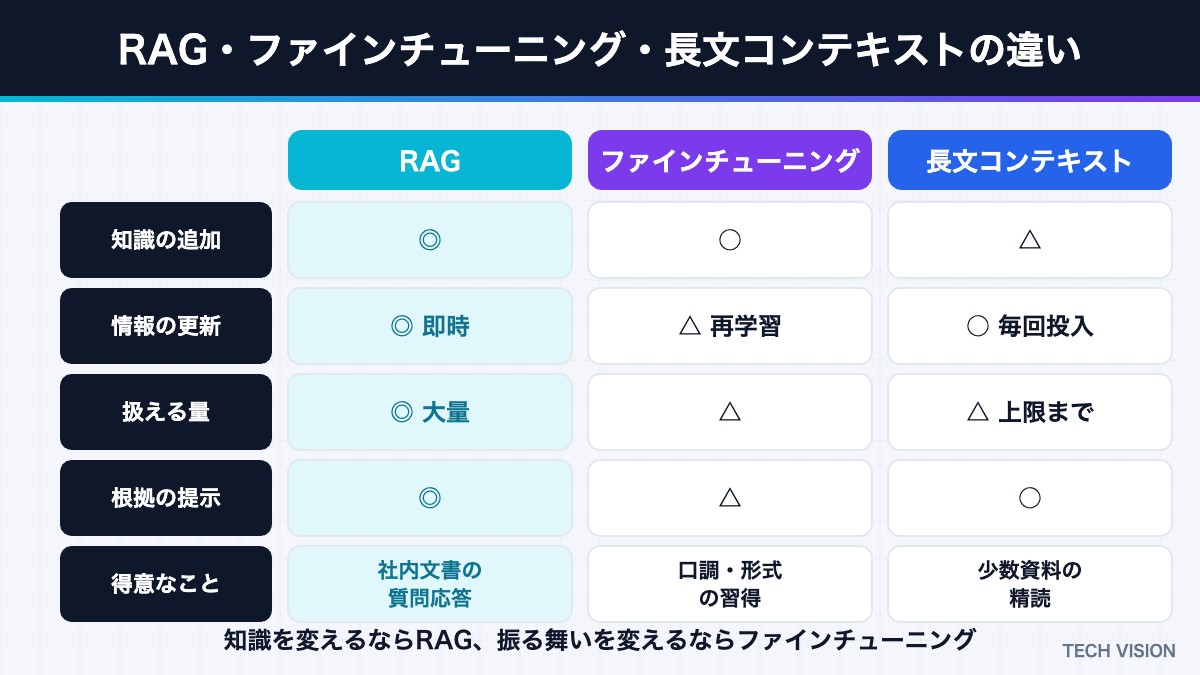 RAG・ファインチューニング・長文コンテキストの違いの比較表
AIに独自の知識を持たせる方法は、RAGだけではない。よく比較されるのがファインチューニング(追加学習)と、資料をまるごと入力に入れる長文コンテキストの活用である。
| 比較項目 | RAG | ファインチューニング | 長文コンテキスト |
|---|---|---|---|
| 知識の追加 | 得意(文書を足すだけ) | 不向き(覚えさせにくい) | 得意(資料を入れるだけ) |
| 情報の更新 | 文書の差し替えで即時 | 再学習が必要 | 毎回入れ直す |
| 扱える文書量 | 大量でも可 | 学習データ次第 | 入力の上限まで |
| 根拠の提示 | しやすい | 難しい | 可能 |
| 1回あたりの費用 | 小さい | 推論は小さいが学習費用が大きい | 入力が長いほど大きい |
| 向いている用途 | 社内文書の検索・質問応答 | 口調・出力形式・専門的な作法の習得 | 少数の資料をじっくり読ませる作業 |
基本の使い分けは、「何を知っているか」を変えたいならRAG、「どう振る舞うか」を変えたいならファインチューニングである。両者は対立するものではなく、組み合わせて使うこともできる。
長文コンテキストについては、「一度に大量の文章を読めるモデルが増えたので、RAGは不要になるのではないか」という議論がある。確かに、数本の契約書を比較するような作業なら、全文を入れるほうが手軽で精度も出やすい。しかし、数千〜数万件の文書を対象にする場合、毎回すべてを入力するのは費用と速度の面で現実的ではない。また、入力が長くなるほど、途中にある情報を見落としやすくなる傾向も指摘されている。大量の文書から必要な部分を選ぶ役割として、RAGの価値はむしろ高まっているといえる。
RAGでできること:代表的な活用例
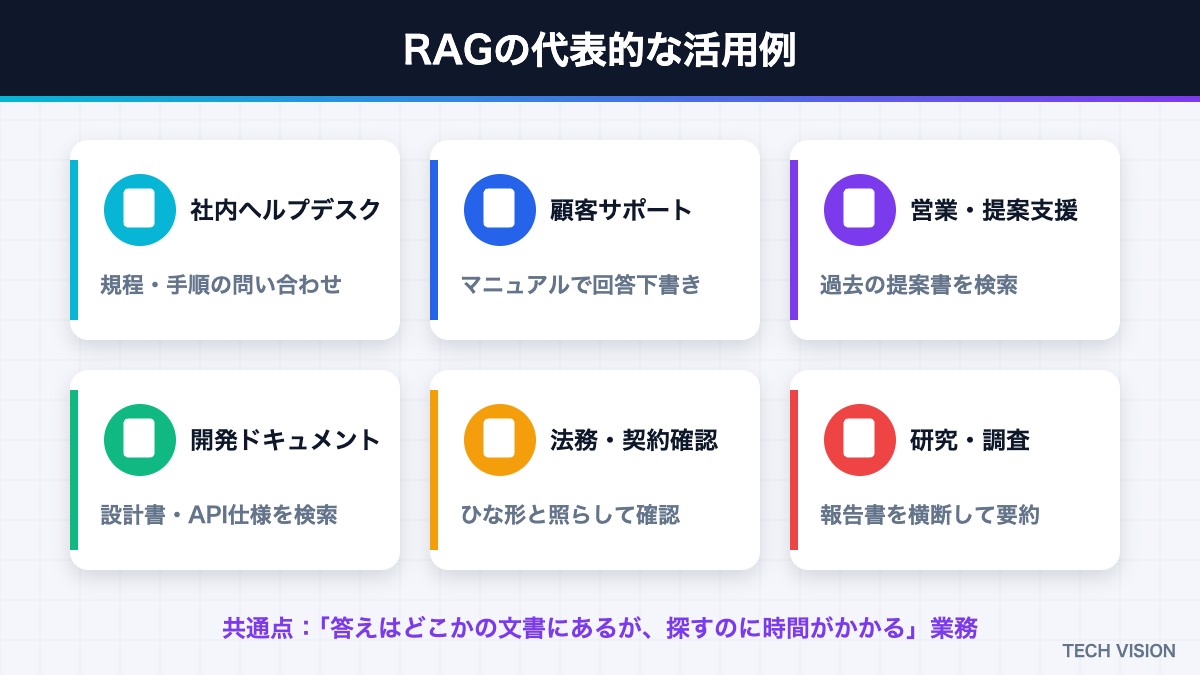 RAGの代表的な活用例6つ
RAGは「文書にもとづいて答える」仕組みなので、文書が蓄積されている業務ほど効果が出やすい。代表的な活用例を挙げる。
- 社内ヘルプデスク:就業規則、経費精算、ITの手順などの問い合わせに、規程を根拠に回答する
- 顧客サポート:製品マニュアルや過去の対応履歴をもとに、回答の下書きを作る
- 営業・提案支援:過去の提案書や事例集から、似た案件の情報を探して要約する
- 開発ドキュメント検索:設計書、API仕様、障害報告から該当箇所を探して説明する
- 法務・契約確認:契約書のひな形や社内基準と照らして、確認すべき条項を示す
- 研究・調査:論文や報告書の集まりから、特定のテーマに関する記述を横断的に集める
RAGに取り込む文書は、会議の議事録のように日々の業務で生まれる記録ほど価値が高い。会議を録音して文字起こし・要約まで自動で行えるAI議事録デバイスを使えば、検索対象となる記録を無理なく蓄積できる。

PR:Plaud(AI議事録デバイス)
共通するのは、「答えはどこかの文書に書いてあるが、探すのに時間がかかる」という状況である。反対に、文書に答えが書かれていない問い(将来の予測や、新しい企画の発想など)には、RAGはあまり効かない。
RAGが向いていないケース
次のような場合は、RAG以外の方法を検討したほうがよい。
- 集計や計算が中心の質問:「先月の部署別の売上合計は?」といった問いは、文書検索よりもデータベースへの問い合わせ(SQLなど)を組み合わせるほうが正確である
- 文書が少なく、全文を毎回入れられる:数ページの資料なら、長文コンテキストでまるごと渡すほうが手軽で精度も出やすい
- 文書そのものが整備されていない:情報がメールや個人のメモに散らばっている状態では、まず文書を整える作業が先になる
RAGの作り方:7つのステップ
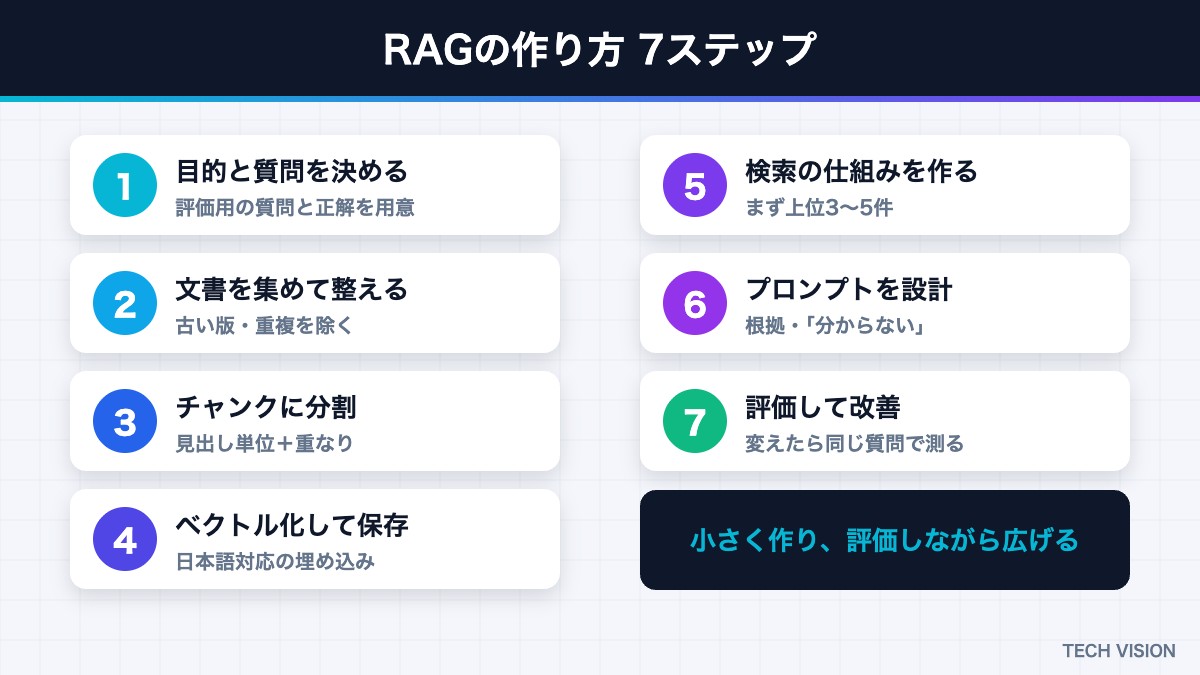 RAGの作り方7ステップ
ここからは、実際にRAGを作る手順を7つのステップで説明する。最初から大規模に作るのではなく、対象を絞って小さく作り、評価しながら広げていくのが失敗しにくい進め方だ。
ステップ1:目的と「答えさせたい質問」を決める
最初に決めるべきは、技術ではなく誰のどんな質問に答えるのかである。実際に寄せられている問い合わせを20〜50件ほど集め、それぞれの正解と、正解が書かれている文書を対応づけておく。これが後の評価用データになる。
ステップ2:文書を集めて整える
対象となる文書を集め、古い版や重複を取り除く。RAGの精度を最も大きく左右するのがこの工程だ。古い規程と新しい規程が混在していれば、AIは古いほうを根拠に答えてしまう。文書ごとに更新日、部署、公開範囲といった属性(メタデータ)を付けておくと、あとで絞り込み検索に使える。
ステップ3:チャンクに分割する
長い文書を、検索の単位となるチャンクに分ける。分割の方法は次の章で詳しく扱うが、まずは見出し単位で区切り、長すぎる部分をさらに分ける方法から始めるとよい。
ステップ4:埋め込みモデルでベクトル化して保存する
チャンクを埋め込みモデルでベクトルに変換し、ベクトルデータベースに保存する。埋め込みモデルは日本語に対応した多言語モデルを選ぶ。保存先は、PostgreSQLに拡張機能のpgvectorを追加する方法や、Chroma、Qdrant、Weaviateといった専用のデータベース、クラウド各社の検索サービスなど選択肢が多い。小規模な検証であれば、手元で動く軽量なものから始めて問題ない。なお、埋め込みモデルを後から変更すると、すべての文書をベクトル化し直す必要がある。最初の段階で、日本語の評価用の質問を使って複数のモデルを比べておくと手戻りが少ない。
ステップ5:検索の仕組みを作る
質問をベクトル化し、意味が近いチャンクを上位数件取り出す処理を作る。取り出す件数は、多すぎると関係の薄い情報が混ざり、少なすぎると必要な情報を取りこぼす。まずは3〜5件程度から始め、評価結果を見て調整する。
ステップ6:プロンプトを設計する
検索したチャンクをLLMに渡す指示文を作る。最低限、次の4点を含めておきたい。
- 渡した資料の内容だけにもとづいて答えること
- 資料に答えがない場合は「資料からは分からない」と答えること
- 回答の根拠となった資料の名前や箇所を示すこと
- 回答の形式(箇条書き、文字数、敬語など)
特に「分からないときは分からないと答える」指示は重要だ。これがないと、資料に答えがないときにモデルが一般知識で補ってしまい、RAGを使う意味が薄れる。
ステップ7:評価して改善する
ステップ1で用意した質問を使い、検索と回答の品質を測る。評価の方法は後の章で説明する。設定を一つ変えたら、同じ質問で測り直す。この繰り返しが、RAGの精度を上げる唯一の確実な方法である。
チャンク分割と検索のコツ
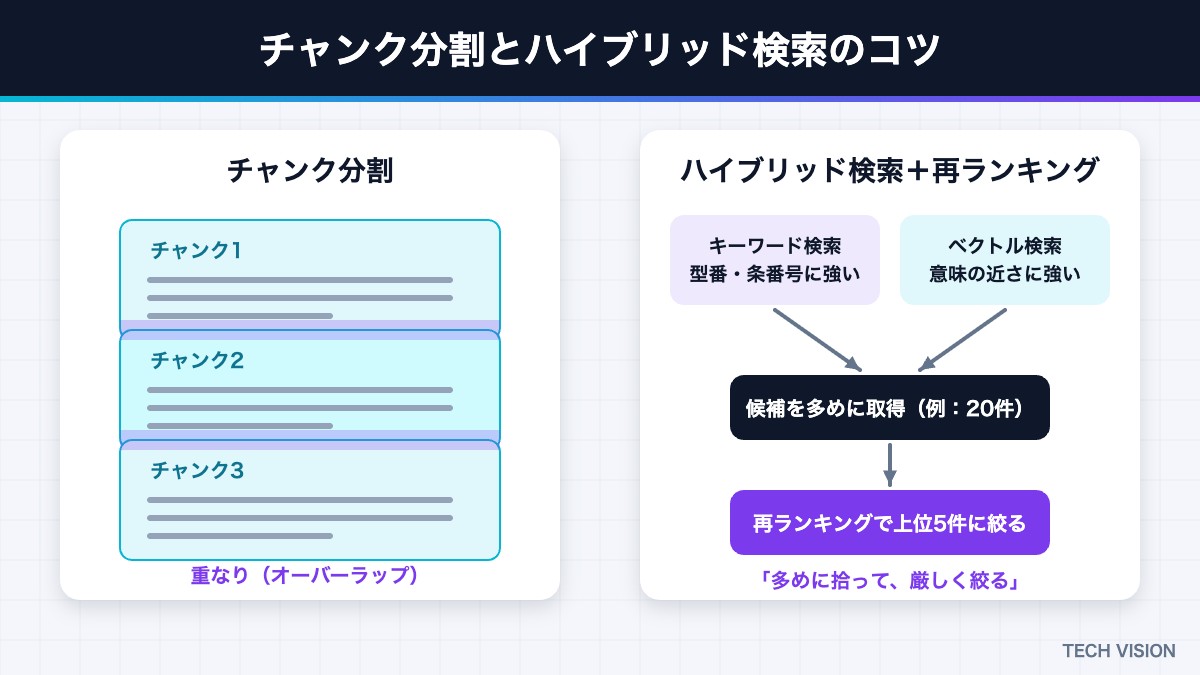 チャンク分割のオーバーラップとハイブリッド検索・再ランキングの仕組み
RAGがうまく動かない原因の多くは、生成ではなく検索にある。必要な情報が検索で取り出せていなければ、どれほど高性能なモデルでも正しく答えられない。
チャンクの大きさと重なり
チャンクが小さすぎると文脈が失われ、「この場合」「上記の条件」といった言葉が何を指すのか分からなくなる。大きすぎると、関係のない内容が混ざって検索の精度が落ちる。日本語の文書では、数百〜千文字程度を目安に、前後のチャンクと少しずつ重ねて分割する方法がよく使われる。重ねておくことで、区切りの位置に大事な情報があっても取りこぼしにくくなる。
文書の構造を活かす
機械的に文字数で切るより、見出し、条文、FAQの問いと答えといった文書の構造に沿って切るほうが精度は安定する。さらに、各チャンクに「どの文書の、どの見出しの部分か」という情報を付け加えておくと、検索でも回答でも文脈が伝わりやすくなる。表は行と列の関係が崩れないよう、Markdown形式などに変換してから扱うとよい。
ハイブリッド検索と再ランキング
ベクトル検索は意味の近さで探すのが得意な反面、製品の型番や規程の条番号、固有名詞のような文字どおり一致してほしい語には弱いことがある。そこで、従来のキーワード検索とベクトル検索を組み合わせるハイブリッド検索が広く使われている。
さらに、検索で多めに候補を取り出したあと、質問との関連度をより精密に判定するモデルで並べ替える再ランキング(リランキング)を加えると、上位に本当に必要な情報が来やすくなる。「多めに拾って、厳しく絞る」が検索設計の基本形だ。
検索結果をそのまま渡さない工夫
検索で取り出したチャンクは、そのままの順番で渡すより、同じ文書のチャンクをまとめ、文書の中での順序に並べ直してから渡すほうが、モデルが内容を理解しやすい。また、ほぼ同じ内容のチャンクが複数取れた場合は重複を除いておくと、限られた入力の枠を有効に使える。小さな工夫だが、回答の分かりやすさに直結する。
RAGの精度を上げる8つのコツ
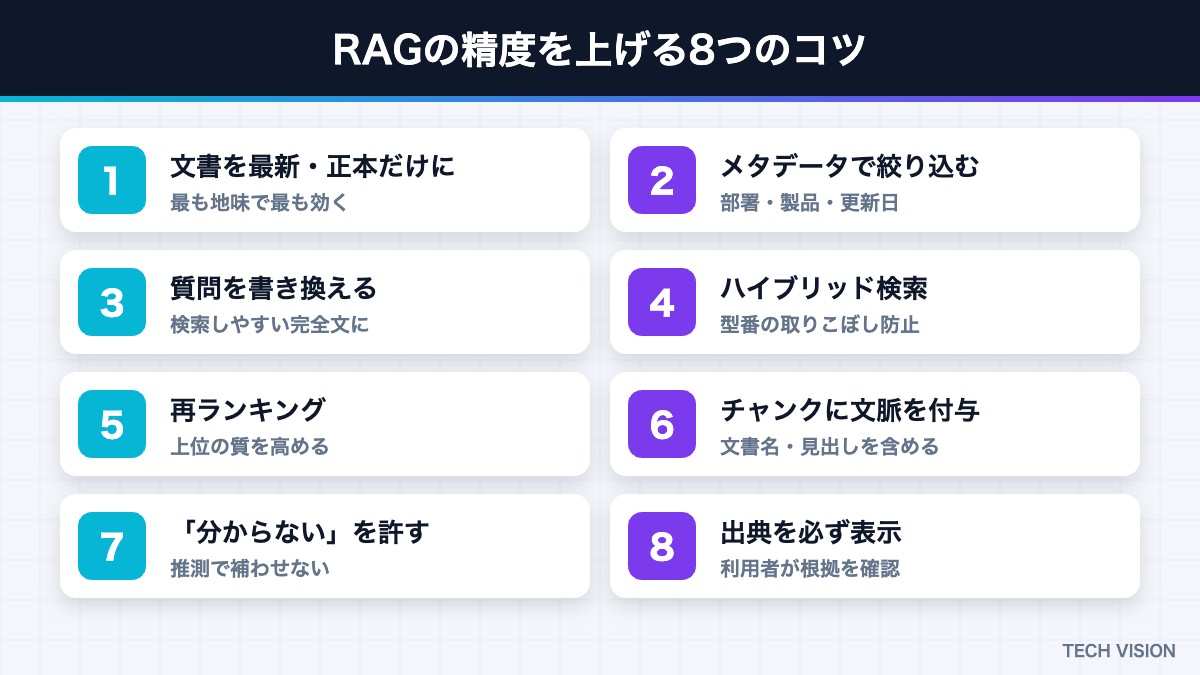 RAGの精度を上げる8つのコツ
基本の仕組みを作ったうえで、精度を上げるために効果の大きい工夫を8つ挙げる。すべてを一度に行う必要はなく、評価で弱点が見えた部分から順に試すとよい。
- 文書を最新・正本だけにする:古い版や下書きを検索対象から外す。最も地味だが最も効く
- メタデータで絞り込む:部署、製品、更新日などで検索範囲を絞ると、似た別の文書を拾う誤りが減る
- 質問を書き換える:あいまいな質問や会話の続きの質問を、検索しやすい完全な文に直してから検索する
- ハイブリッド検索を使う:キーワード検索とベクトル検索を組み合わせ、型番や固有名詞の取りこぼしを防ぐ
- 再ランキングを加える:多めに取り出した候補を並べ替え、上位の質を高める
- チャンクに文脈を付ける:文書名や見出しをチャンクに含め、断片だけでも意味が通るようにする
- 「分からない」を許す指示を入れる:資料にない内容を推測で補わせない
- 出典を必ず表示する:利用者が根拠を確認でき、誤りに気づいたときの報告もしやすくなる
逆に、精度が出ないときに真っ先にモデルを高性能なものへ替えるのは、効果が小さいことが多い。まず検索で正しい資料が取れているかを確認し、そのうえで生成の問題かどうかを切り分けるのが遠回りに見えて近道である。
RAGの評価方法:検索と回答を分けて測る
RAGの評価では、検索の品質と回答の品質を分けて測ることが重要だ。回答が間違っていても、原因が検索にあるのか生成にあるのかで対処が変わる。
| 評価の観点 | 確認すること |
|---|---|
| 検索の再現性 | 正解が書かれた文書が、検索結果の上位に含まれているか |
| 検索の適合性 | 検索結果に、関係のない文書がどれだけ混ざっているか |
| 回答の忠実性 | 回答が、渡した資料に書かれた内容だけにもとづいているか |
| 回答の正確性 | 回答が、用意した正解と一致しているか |
| 回答の有用性 | 質問に対して過不足なく、使える形で答えているか |
たとえば評価用の質問を30件用意し、「正解の文書が検索結果の上位5件に入った割合」と「回答が正解と一致した割合」を記録しておく。前者が低ければ分割や検索の設計を見直し、前者は高いのに後者が低ければプロンプトやモデルを見直す、というように、数字を見れば次に手を入れる場所が決まる。
評価は、最初は人の目で行うのが確実だ。件数が増えてきたら、別のLLMに採点させる方法(LLMによる評価)を併用すると効率が上がる。ただし、自動採点の結果は定期的に人が抜き取りで確認し、採点の基準がずれていないかを見ておきたい。本番運用が始まったら、利用者の「役に立った・立たなかった」の反応や、答えられなかった質問の記録を集め、文書の追加や改善に回していく。
RAGを始める3つの方法:ノーコード・フレームワーク・自作
RAGを導入する方法は、大きく三つに分けられる。目的と社内の体制に合わせて選びたい。
| 方法 | 概要 | 向いているケース |
|---|---|---|
| ノーコードのサービス | AIサービスや社内向けAIツールに文書を登録するだけで使える | まず効果を確かめたい、開発の人手がない |
| 開発フレームワーク | RAG向けの部品がそろったライブラリを組み合わせて作る | 社内システムと連携したい、検索の設計を調整したい |
| 自作 | 検索、データベース、プロンプトをすべて自前で設計する | 大規模・高い要件がある、細かな制御が必要 |
最初からすべてを自作する必要はない。ノーコードで効果と課題を確かめ、足りない部分が見えたらフレームワークで作り直すという段階的な進め方が、費用と時間の無駄を最も減らせる。どの方法を選んでも、評価用の質問と正解を用意しておけば、乗り換えたときに品質を比較できる。
ローカルLLMでRAGを作る構成例
社外に出せない文書を扱う場合、RAGの全体を手元の環境で動かす構成が選ばれる。LLMはローカルLLMを使い、埋め込みモデルとベクトルデータベースも社内のサーバーやPCで動かせば、文書も質問も外部に送信されない。
この構成では、生成を担うモデルの規模よりも検索の設計が重要になる。資料に答えが書かれていて、それが正しく検索できていれば、比較的小さなモデルでも十分に実用的な回答を作れることが多い。端末の中で動く小型モデルについてはSLM(小規模言語モデル)の解説記事も参考にしてほしい。
構成の一例は次のとおりである。
- 文書の取り込み:社内のファイルサーバーやWikiから定期的に文書を取得し、テキスト化する
- 埋め込み:日本語に対応した多言語の埋め込みモデルを手元で動かす
- 保存・検索:軽量なベクトルデータベース、またはPostgreSQLとpgvector
- 生成:ローカルLLMを社内API化して呼び出す
- 画面:社内チャットツールやブラウザ画面から質問できるようにする
進化するRAG:エージェント型RAG・GraphRAG・MCP連携
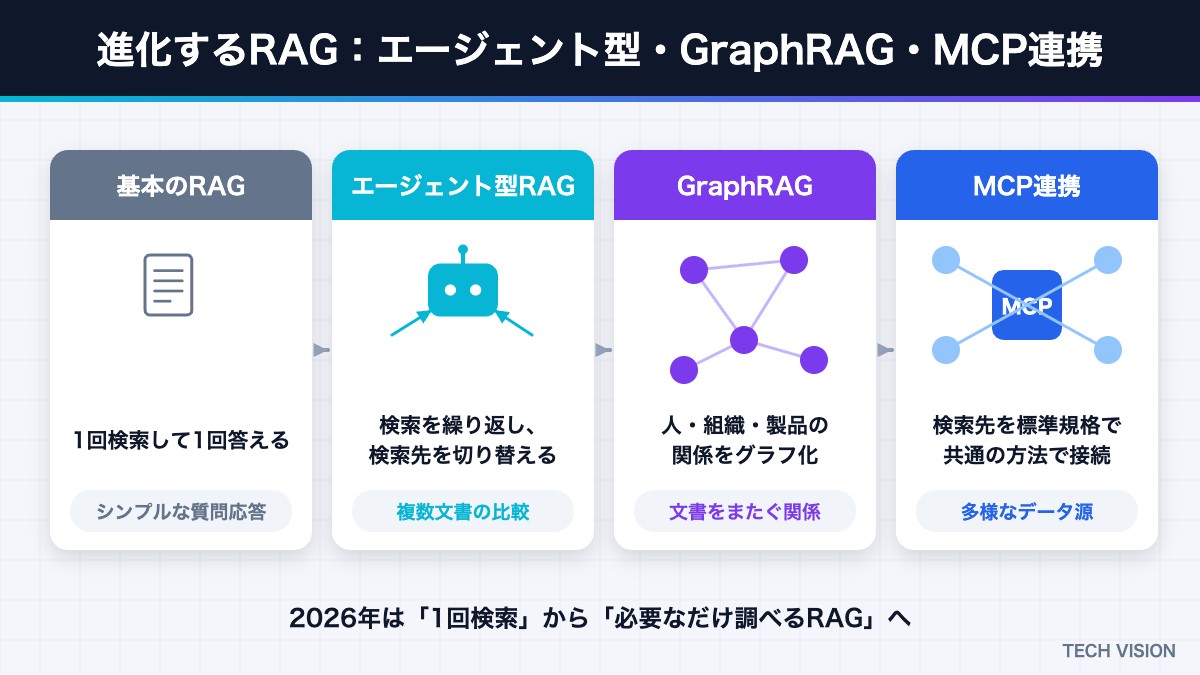 進化するRAG(エージェント型RAG・GraphRAG・MCP連携)
RAGは「1回検索して1回答える」基本形から、より複雑な質問に対応する方向へ進化している。2026年時点で注目されている流れを三つ紹介する。
エージェント型RAG
AIエージェントが、質問の内容に応じて検索を何度も繰り返したり、検索先を切り替えたりしながら答えを組み立てる方式である。「A製品とB製品の保証条件の違いは?」のように複数の文書を比べる必要がある質問でも、必要な情報を段階的に集めてから回答できる。一方で、処理時間と費用は増えるため、単純な質問には基本形のRAGを使い分ける設計が現実的だ。
GraphRAG
文書に登場する人物、組織、製品などの関係をグラフ(つながりの図)として整理し、検索に使う手法である。「この部署が関わった案件で、同じ取引先が登場するものは?」といった、複数の文書をまたいだ関係を問う質問に強い。構築の手間は大きいが、文書同士のつながりに価値がある領域で効果を発揮する。
MCPによる検索先の標準化
社内のファイル、データベース、業務システムなど、検索先がばらばらだとRAGの構築は複雑になる。そこで、AIと外部のツールやデータをつなぐ標準規格であるMCP(Model Context Protocol)を使い、検索先を共通の方法で接続する構成が広がっている。検索先を追加するたびに独自の連携を作る必要が減り、エージェント型RAGとの相性もよい。
RAG導入時の注意点:権限・セキュリティ・費用
業務でRAGを使う際には、精度以外にも押さえておくべき点がある。
- 閲覧権限の反映:検索対象に人事情報や役員向けの資料が含まれる場合、本来見られない人の質問に答えてしまうおそれがある。元の文書の閲覧権限を検索にも反映させる設計が必須だ
- プロンプトインジェクション:文書の中に「以前の指示を無視せよ」といった文章が紛れ込むと、AIの動作が乗っ取られる可能性がある。外部から取り込んだ文書は特に注意したい
- 個人情報の扱い:検索対象に個人情報が含まれる場合、利用目的と保存範囲を社内のルールと照らして確認する
- 費用の見積もり:埋め込みの計算、データベースの運用、LLMの利用料がかかる。検索で渡すチャンクの量が増えるほど、1回あたりの費用も上がる
- 文書の更新運用:文書が更新されたときに、自動でインデックスを作り直す仕組みを用意しておかないと、すぐに古い情報で答えるRAGになってしまう
RAGでよくある失敗とチェックリスト
RAGを作ってみたものの期待した結果が出ないとき、次の点を順に確認してほしい。
- 正解が書かれた文書は、そもそも検索対象に入っているか
- 古い版や重複した文書が混ざっていないか
- 表や箇条書きが、テキスト化の段階で崩れていないか
- チャンクが小さすぎて、文脈が切れていないか
- 型番や条番号のような語が、ベクトル検索だけで探されていないか
- 検索結果の上位に、正解の文書が入っているか(生成の前に確認したか)
- 「資料にない場合は分からないと答える」指示が入っているか
- 評価用の質問と正解が用意され、変更のたびに測り直しているか
よくある質問
Q. RAGを作るのにプログラミングは必要ですか?
A. 本格的に作るなら必要ですが、最近はクラウドのAIサービスや社内向けのAIツールに、文書をアップロードするだけで検索と回答ができる機能が備わっているものも多くあります。まずはそうした機能で効果を確かめ、要件が固まってから独自に作る判断をしても遅くありません。
Q. RAGを使えばハルシネーションはなくなりますか?
A. 大きく減らせますが、ゼロにはなりません。検索で誤った資料を拾えば誤った回答になり、資料の読み違いも起こり得ます。出典の表示と、重要な用途での人による確認を組み合わせることが大切です。
Q. 対象の文書は何件くらいから効果がありますか?
A. 件数よりも、「探すのに時間がかかっているか」が判断基準です。数十件でも頻繁に問い合わせが来る規程集なら効果がありますし、数万件あっても誰も参照しない文書なら優先度は低くなります。
Q. PDFやスキャンした書類も使えますか?
A. 使えます。ただし、スキャン画像は文字認識(OCR)が必要で、表や段組みの多いPDFはテキスト化で構造が崩れやすいため、変換結果を確認する工程を入れてください。画像ごと理解できるモデルを使って変換精度を上げる方法もあります。
Q. ファインチューニングとどちらを先に試すべきですか?
A. 社内の知識にもとづいて答えさせたいのであれば、まずRAGを試すのがおすすめです。準備の手間が小さく、文書の更新にもすぐ対応できます。回答の口調や形式を細かくそろえたい場合に、ファインチューニングを検討してください。
Q. 英語の文書と日本語の質問を組み合わせられますか?
A. 多言語対応の埋め込みモデルを使えば、言語が異なっていても意味の近い文書を検索できます。ただし精度は同じ言語どうしより下がることがあるため、評価用の質問で確認しておくと安心です。
Q. 回答までに時間がかかりすぎる場合はどうすればよいですか?
A. 検索で渡すチャンクの数を減らす、再ランキングの対象件数を絞る、生成に使うモデルを軽いものにする、といった方法があります。よく聞かれる質問は回答を一時保存して再利用する仕組みも効果的です。どこで時間がかかっているかを計測してから対処しましょう。
Q. 社内に導入したあと、誰が運用すればよいですか?
A. 仕組みの保守は情報システム部門、文書の内容と更新は各業務部門、というように役割を分けるのが一般的です。答えられなかった質問を定期的に見直し、足りない文書を追加する担当者を決めておくと、精度が継続的に上がっていきます。
まとめ:RAGは「検索の設計」で決まる
RAGは、モデルを作り直さずに、手元の文書にもとづいて答えるAIを作るための最も実践的な方法である。最後に要点を振り返る。
- RAGは「調べてから答える」仕組み。知識はモデルではなくデータベース側に置く
- 知識を足すならRAG、振る舞いを変えるならファインチューニング
- 精度を左右するのは、文書の整備・チャンク分割・検索の設計
- ハイブリッド検索と再ランキングで、検索の取りこぼしを減らす
- 評価用の質問を用意し、検索と回答を分けて測りながら改善する
- 業務では、閲覧権限の反映と文書の更新運用を最初から設計に入れる
最初の一歩としては、問い合わせの多い文書を一つの分野に絞り、20件ほどの質問と正解を用意して、小さなRAGを作ってみることをおすすめしたい。どこで答えが外れるのかを一つずつ確かめていくことが、使えるRAGへの最短距離である。
※本記事の情報は2026年9月時点のものです。紹介したツールやサービスの仕様は変更される場合があるため、導入の際は各提供元の公式情報をご確認ください。