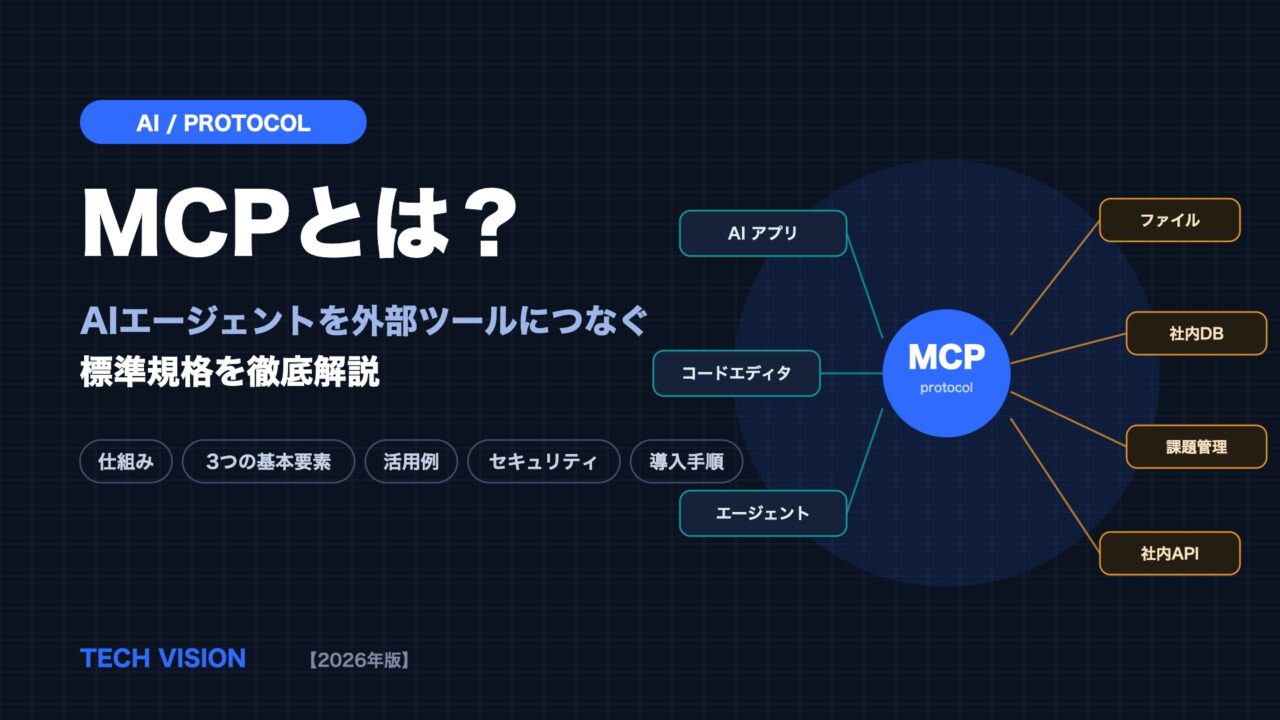
生成AIは、文章を書き、コードを提案し、画像を読み取るところまで日常の道具になった。しかし、多くの現場で聞こえてくる不満は同じだ。「社内の資料を見てくれない」「チケットの状況を知らない」「結局こちらがコピー&ペーストしている」。モデルが賢くなっても、手元のデータや業務システムにつながっていなければ、仕事はなかなか前に進まない。
その接続部分を標準化しようとしているのがMCP(Model Context Protocol)である。2024年11月にAnthropicがオープンな仕様として公開し、その後は多くのAIツールや開発環境が対応を進め、AIアプリと外部データ・ツールをつなぐ共通規格として定着しつつある。
MCPは、しばしば「AIアプリにとってのUSB-Cのようなもの」と表現される。以前はツールごとに専用の接続を作り込む必要があったが、共通の作法に沿ってサーバーを一つ用意すれば、対応するさまざまなAIクライアントから同じように利用できる。
本稿では、MCPが解決しようとしている課題、アーキテクチャと基本要素、通信の流れ、代表的な活用例、セキュリティ上の注意点、企業が導入するときの進め方までを、2026年9月時点の情報をもとに整理する。仕様やツールの対応状況は更新が速いため、実装前には必ず公式ドキュメントで最新の内容を確認してほしい。
この記事の要点
- MCPは、AIアプリと外部のデータ・ツールを接続するためのオープンな標準プロトコルである
- 2024年11月にAnthropicが公開し、その後は複数のAIベンダーや開発ツールが採用を進めている
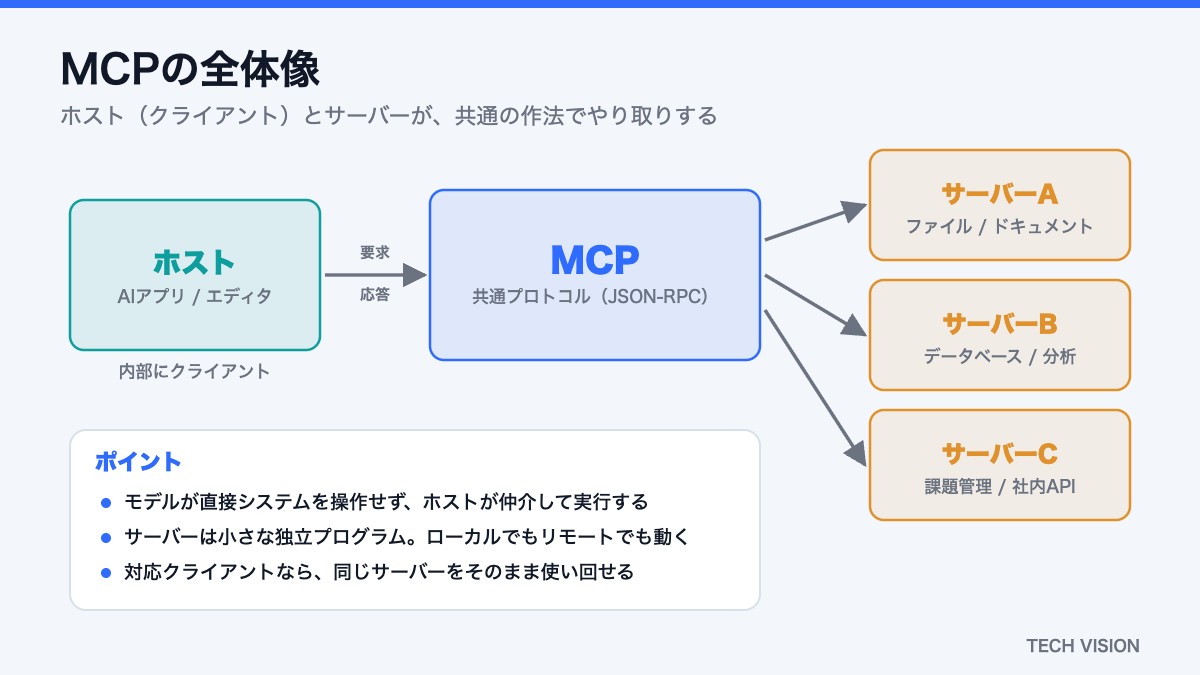
- ホスト/クライアント/サーバーという構成で、JSON-RPCを用いてやり取りする
- サーバーは主にツール(Tools)、リソース(Resources)、プロンプト(Prompts)を提供する
- 統合の組み合わせ爆発(いわゆるN×M問題)を、共通仕様によってN+Mに近づけることが狙いである
- 便利さと引き換えに、権限の与えすぎ、プロンプトインジェクション、出所不明のサーバーといったリスクがある
- 導入は、小さく試す→権限と監査を設計する→段階的に広げる、という順序が現実的である
MCPとは何か:AIと外部世界をつなぐ共通規格
MCP(Model Context Protocol)は、AIアプリケーションが外部のデータソースやツールを利用するためのオープンなプロトコルである。ファイルの読み取り、データベースへの問い合わせ、チケットの作成、外部APIの呼び出しといった操作を、決められた形式でAIに提供する仕組みを定めている。
「つなぎ込み」を標準化するという発想
大規模言語モデル(LLM)は、学習した知識と、そのとき渡された文脈(コンテキスト)にもとづいて回答する。社内の仕様書や当日の売上データのように、学習データに含まれない情報は、誰かが文脈として渡さなければ扱えない。
これまでは、その受け渡しをアプリごとに実装してきた。チャットツール用のコネクタ、IDE用のプラグイン、独自の関数呼び出し。どれも似た処理を、それぞれの流儀で書き直す作業だった。MCPは、この接続方法そのものを共通化する。
プロトコルであって、モデルではない
混同されやすいが、MCPはAIモデルでもアプリでもない。やり取りの約束事である。HTTPがブラウザとサーバーの会話の作法を定めるように、MCPはAIアプリと外部ツールの会話の作法を定める。そのため、特定のモデルに依存せず、対応する環境であれば同じサーバーを使い回せる。
誰が作り、どう広がったのか
MCPは2024年11月にAnthropicがオープンソースとして公開した。仕様とSDK、参照実装が公開され、開発者が自由にサーバーを作れるようにしたことが普及の起点になった。その後、開発者向けツールやAIクライアントを中心に採用が広がり、他のAIベンダーも対応を表明するなど、特定企業の囲い込みではない共通基盤として扱われるようになっている。
なぜMCPが必要になったのか:N×M問題
MCPの価値は、技術的な新しさよりも、開発の手間を減らす構造にある。
組み合わせの数が開発を圧迫する
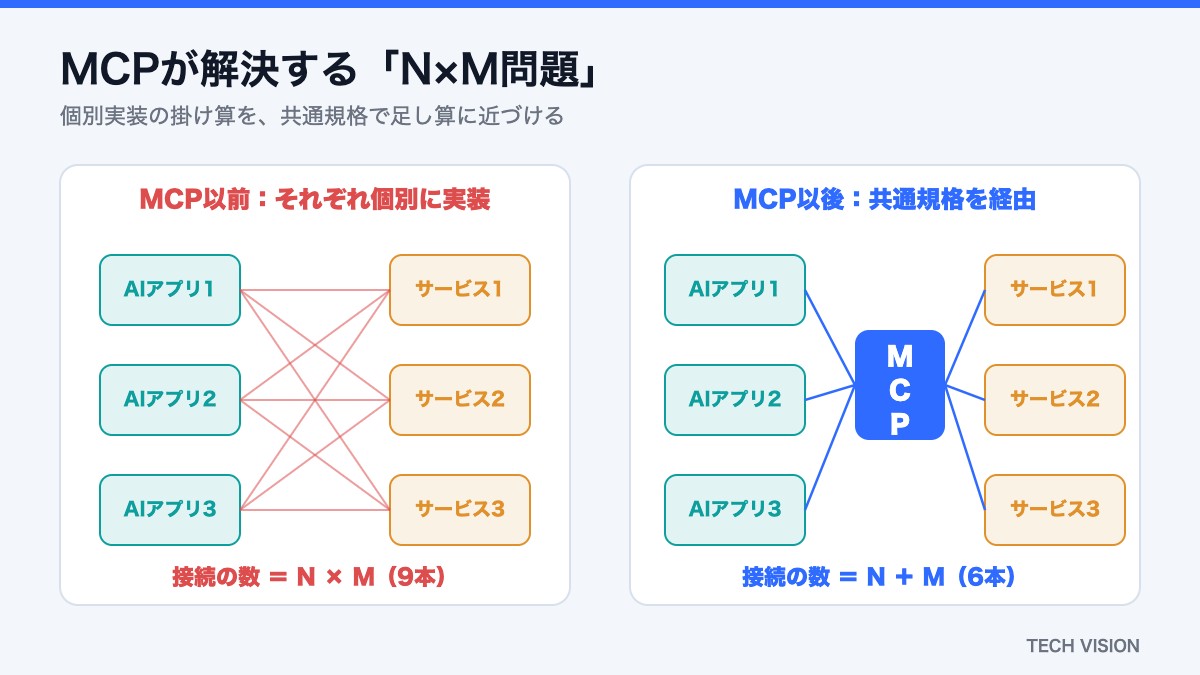
AIアプリがN個、つなぎたい外部サービスがM個あるとき、個別に実装すれば理論上N×Mの接続を作ることになる。アプリが増えても、サービスが増えても、組み合わせは掛け算で増えていく。仕様変更のたびに、どの接続に影響するかを調べる作業も必要になる。
共通仕様なら「N+M」に近づく
共通のプロトコルがあれば、各サービスはMCPサーバーを一つ用意し、各アプリはMCPクライアントの機能を一度実装すればよい。組み合わせの数はN+Mに近づき、エコシステム全体の負担が下がる。公開されているサーバーを取り込めば、自前の実装をさらに減らせる。
利用者側のメリット
利用者にとっては、「別のAIツールに乗り換えたら、また全部つなぎ直し」という事態を避けやすくなる意味が大きい。接続の作り方が共通であるほど、ツール選択の自由度は上がる。
MCPのアーキテクチャ:ホスト・クライアント・サーバー
MCPの登場人物は三つである。役割を押さえると、設定ファイルやエラーメッセージの意味が理解しやすくなる。
ホスト(Host)
ホストは、利用者が実際に触れるAIアプリケーションを指す。デスクトップのAIチャット、コードエディタ、社内に構築したエージェント基盤などが該当する。どのサーバーに接続するか、どの操作を許可するかを管理するのはホストの役割だ。
クライアント(Client)
クライアントは、ホストの内部でサーバーとの通信を担当する部分である。原則としてサーバーごとに一つのクライアントが対応し、接続の初期化、機能の確認、要求と応答のやり取りを行う。
サーバー(Server)
サーバーは、外部のデータやツールをMCPの形式で提供するプログラムである。ファイルシステム、データベース、課題管理、社内APIなど、対象ごとに用意する。多くは小さな独立したプログラムで、ローカルでも、リモートのサービスとしても動かせる。
実際のデータの流れ
利用者が質問すると、ホストは接続済みサーバーから利用可能な機能の一覧を取得し、モデルに提示する。モデルが特定の操作を選ぶと、ホストが承認の可否を判断(多くの場合は利用者に確認)したうえでサーバーへ要求を送り、返ってきた結果を文脈に加えて回答を組み立てる。モデルが直接外部システムを操作するのではなく、ホストが仲介する点が重要である。
MCPサーバーが提供する三つの基本要素
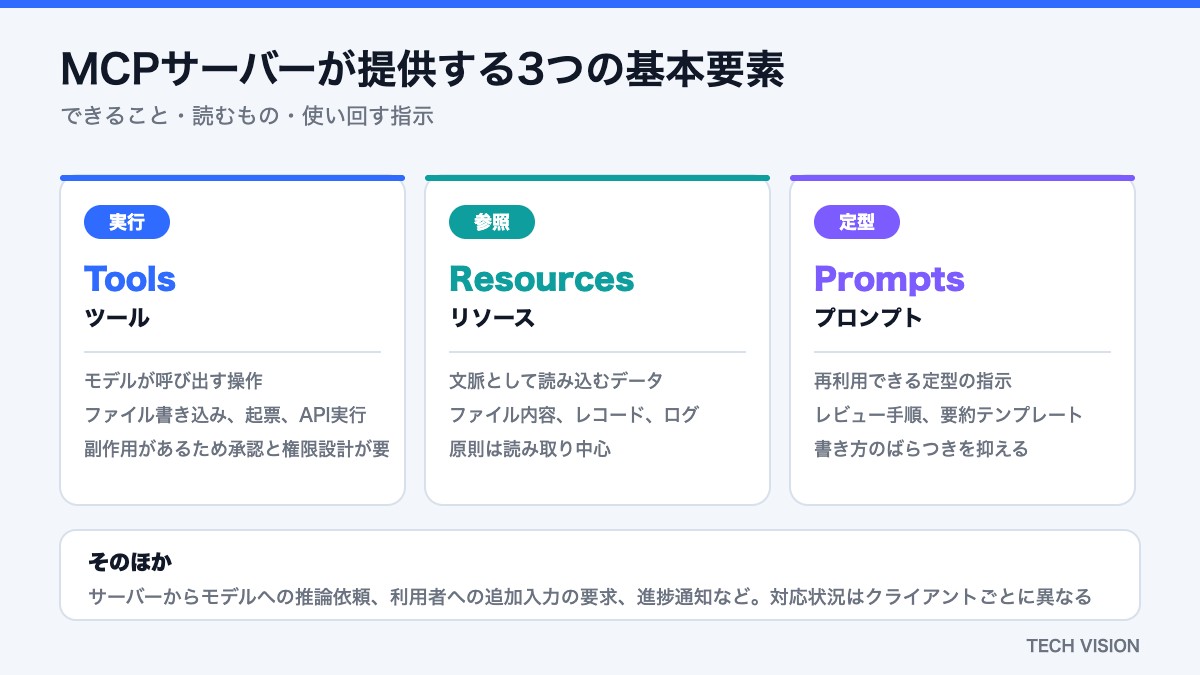
MCPサーバーが提供する機能は、大きく三種類に整理されている。
ツール(Tools):モデルが呼び出す操作
ツールは、実行を伴う機能である。「ファイルを書き込む」「チケットを作成する」「検索APIを呼ぶ」といった操作が該当する。名前、説明、入力の形式(スキーマ)が定義され、モデルはその説明を読んで、どのツールをどの引数で呼ぶかを判断する。副作用を持つため、実行前の承認や権限設計がもっとも重要になる領域でもある。
リソース(Resources):読み取り用のデータ
リソースは、ファイルの内容やレコードなど、文脈として読み込ませるためのデータである。原則として参照が中心で、URIのような識別子で指定する。どのリソースを渡すかは、アプリ側や利用者が選ぶ形が想定されている。
こうしたリソースの代表例が、会議の議事録や商談メモのような日々の記録だ。会議を録音して文字起こし・要約までこなすAI議事録デバイスで記録を整えておくと、AIに読み込ませる文脈として活用しやすくなる。

PR:Plaud(AI議事録デバイス)
プロンプト(Prompts):再利用できる定型指示
プロンプトは、サーバー側が用意する定型のテンプレートである。「このコードをレビューする」「この障害報告を要約する」といった手順を部品として配り、利用者がコマンドのように呼び出せる。属人的な書き方のばらつきを抑える用途に向く。
そのほかの機能
仕様には、サーバーがクライアントを通じてモデルに推論を依頼する仕組みや、利用者に追加入力を求める仕組み、処理の進捗を通知する仕組みなども含まれる。対応状況はクライアントによって異なるため、使いたい機能が実装されているかは事前に確認したい。
通信の流れとトランスポート
MCPはJSON-RPC形式のメッセージをやり取りする。手順そのものは素直で、つまずきやすいのは接続方法(トランスポート)の選択である。
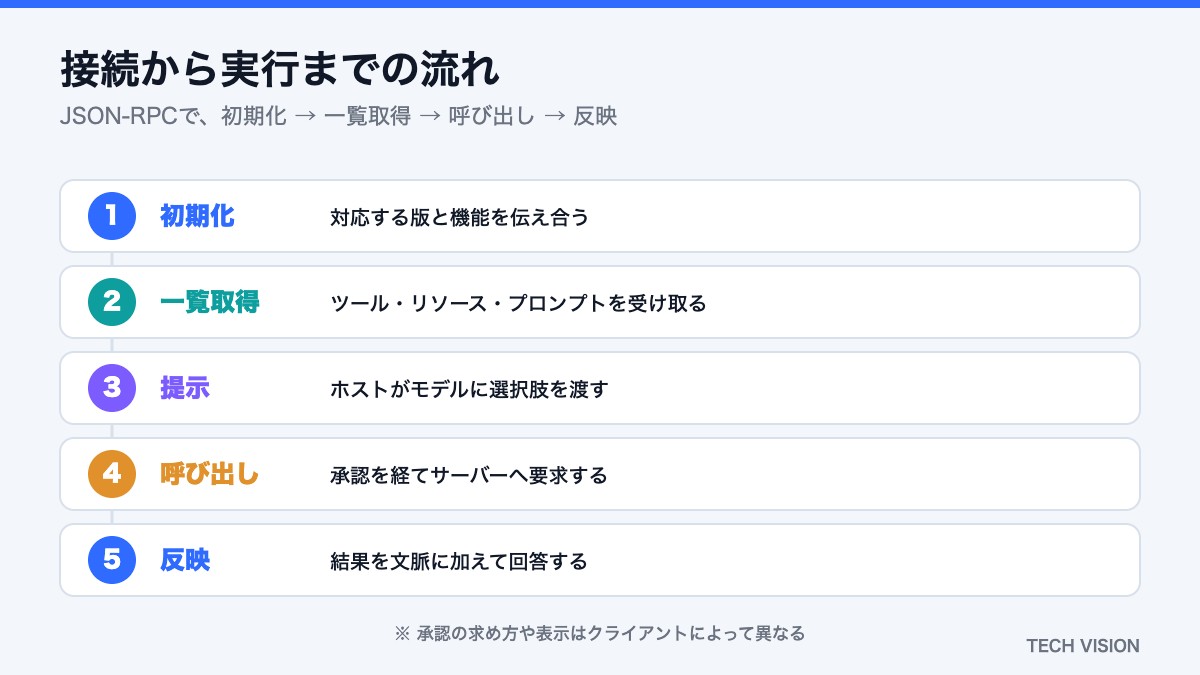
接続から実行までの流れ
おおまかな順序は次のとおりである。
- 初期化:クライアントとサーバーが、対応するプロトコルの版と機能を伝え合う
- 機能の一覧取得:利用できるツール、リソース、プロンプトの一覧を受け取る
- 提示:ホストが、その一覧をモデルに扱える形で渡す
- 呼び出し:モデルが選んだ操作を、ホストの承認を経てサーバーへ要求する
- 結果の反映:返ってきた結果を文脈に加え、回答や次の操作につなげる
ローカル接続(標準入出力)
手元の端末でサーバーを動かす場合は、標準入出力(stdio)を使う方式が基本になる。ホストが子プロセスとしてサーバーを起動し、入出力でやり取りする。設定が簡単で、ローカルのファイルや開発環境を扱う用途に向いている。
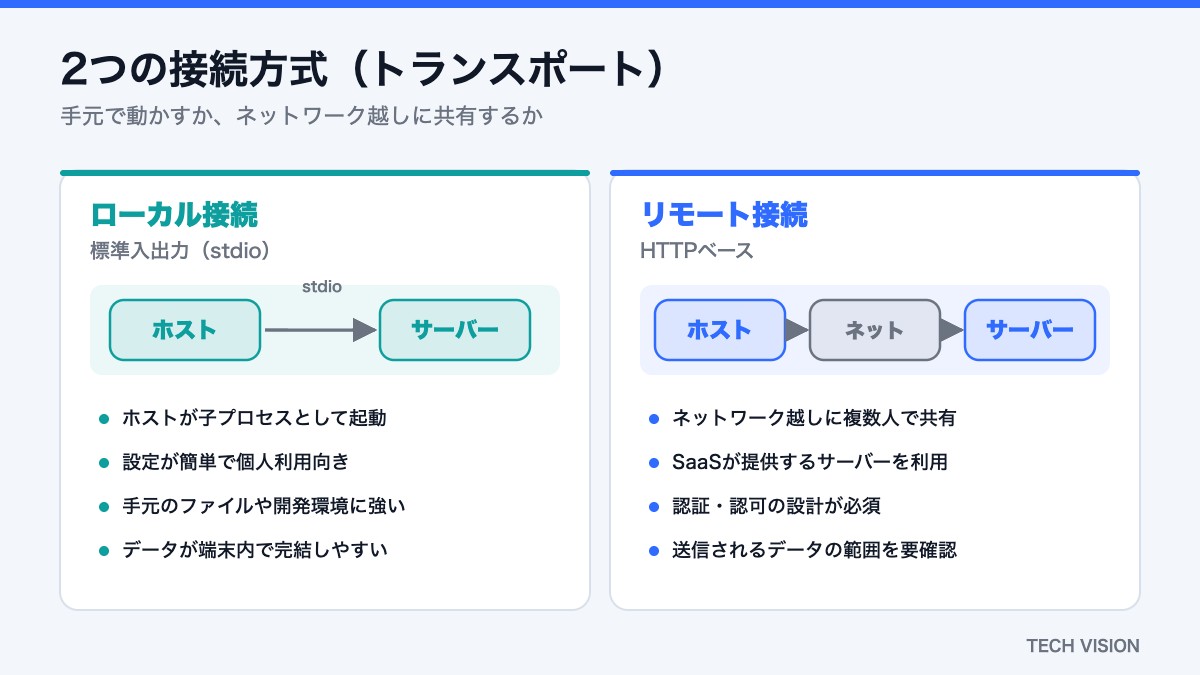
リモート接続(HTTP)
チームで共有したり、SaaS側が提供するサーバーを使ったりする場合は、HTTPベースの接続を用いる。ネットワーク越しに複数の利用者が同じサーバーを使えるため、認証・認可の設計が不可欠になる。利用者ごとの権限をどう分けるか、鍵やトークンをどこに保管するかは、導入前に決めておきたい。
どちらを選ぶか
個人の開発作業や、手元のファイルを扱う用途ならローカル接続が扱いやすい。社内システムとの連携や、複数人での共有を前提にするならリモート接続が現実的だ。両者を併用し、機密度に応じて置き場所を分ける構成もよく採られる。
MCPとRAG・既存の連携方式はどう違うのか
「検索拡張生成(RAG)があればMCPは不要では」という質問をよく受ける。両者は競合ではなく、担当する範囲が異なる。
RAGは「探して渡す」仕組み
RAGは、質問に関連しそうな文書をあらかじめ用意した索引から探し出し、モデルの文脈に加える手法である。社内文書の検索精度を高める用途では今も有効で、MCPの登場によって役割がなくなるわけではない。
MCPは「つなぎ方」を決める仕組み
一方のMCPは、検索に限らずあらゆる操作の接続方法を定める。文書を探すサーバーを作れば検索に、チケットを起票するサーバーを作れば業務操作になる。RAGの検索機能をMCPサーバーとして公開すれば、両者はそのまま組み合わせられる。
使い分けの目安
参照する情報が文書中心で、更新頻度が低く、検索精度が課題ならRAGの作り込みが効く。対象が複数システムにまたがり、読み取りだけでなく操作まで含めたい場合は、MCPで接続を整理する方が拡張しやすい。実務では両方を併用する構成が増えている。
MCPでできること:現場での使われ方
抽象的な説明だけでは価値が伝わりにくいので、代表的な使われ方を挙げる。
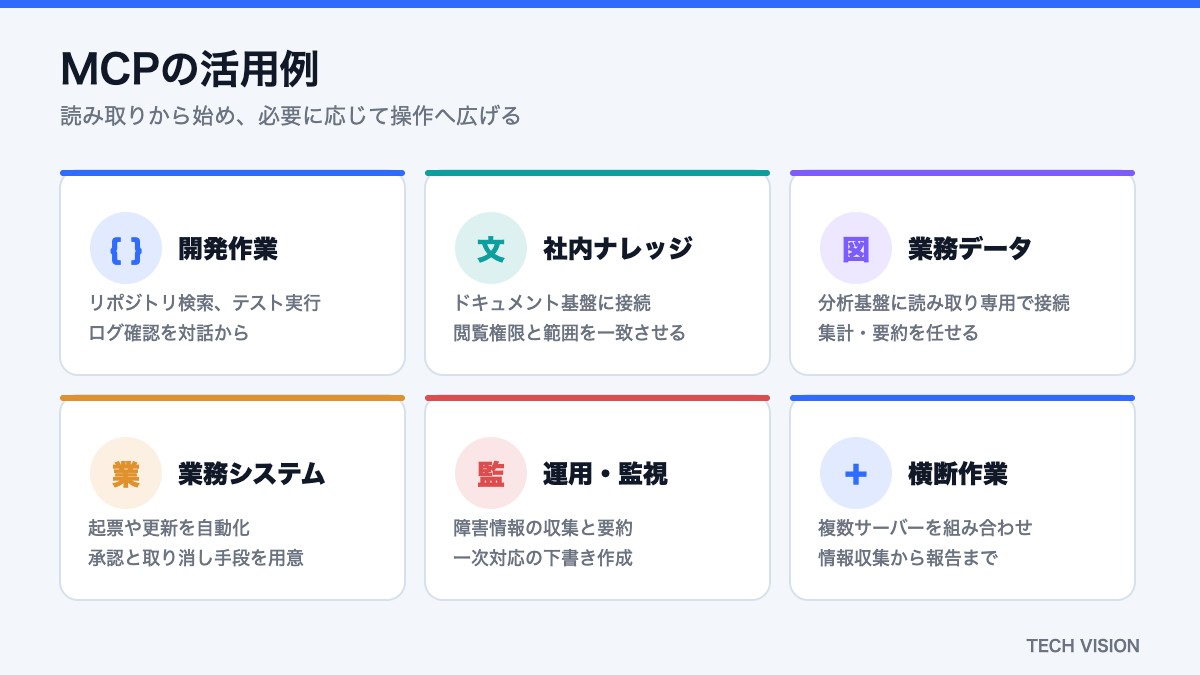
開発作業の自動化
もっとも早く普及したのが開発領域である。リポジトリの検索、課題管理システムの参照、テストの実行、ログの確認などをAIから扱えるようにすると、「状況を集めて整理する」作業が短縮される。コードエディタやCLI型のAI開発ツールが対応を進めたことで、利用者が一気に増えた。
社内ナレッジの検索
ドキュメント基盤やファイルストレージに接続すれば、社内資料を根拠にした回答を得やすくなる。重要なのは、参照範囲を閲覧権限と一致させることだ。AI経由で本来見えない資料が読めてしまう状態は避けなければならない。
業務データの参照とレポート
データベースや分析基盤に読み取り専用で接続し、集計や要約を任せる使い方もある。実務では、更新系の操作を許可せず参照のみに限定するところから始めると事故が起きにくい。
業務システムの操作
チケット作成、顧客情報の更新、社内申請の起票といった操作も、ツールとして提供すれば自動化できる。ただし副作用が大きいため、実行前の確認、取り消し手段、実行ログの保存を合わせて設計したい。
複数サーバーの組み合わせ
MCPの面白さは、複数のサーバーを同時に接続できる点にある。「課題管理から今週の変更点を集め、リポジトリで該当箇所を確認し、報告用の文章にまとめる」といった横断作業を、一つの対話で進められる。
AIコーディングツールと組み合わせた実践については、Claude Codeの使い方を初心者向けにわかりやすく解説やClaude Code完全ガイドもあわせて参考にしてほしい。
MCPサーバーを使う・作るには
既存のサーバーを使う
まずは公開されているサーバーを試すのが近道である。対応するクライアント(デスクトップのAIアプリ、コードエディタ、CLIツールなど)の設定に、サーバーの起動方法や接続先を登録すると、その機能が一覧に現れる。導入時は、提供元が信頼できるか、必要以上の権限を求めていないかを確認したい。
自分で作る
社内システム向けのサーバーは自作することになる。各言語向けのSDKが公開されており、ツールの名前・説明・入力スキーマを定義し、処理を実装する流れが基本である。作り方のコツは次の三点に集約される。
- 説明文を丁寧に書く:モデルは説明を読んで使い方を判断するため、曖昧な説明は誤用につながる
- 入力を検証する:モデルが生成した引数をそのまま信用せず、型と範囲を確認する
- 機能を絞る:「何でもできる万能ツール」より、目的が明確な小さなツールの方が安全で扱いやすい
動作確認とデバッグ
開発時は、検査用のツールを使ってツール一覧や呼び出し結果を確認すると原因を切り分けやすい。実際の運用では、どのツールが、どんな引数で、誰の操作によって呼ばれたかを記録しておくと、問題が起きたときの調査がはるかに楽になる。
導入でつまずきやすいポイント
実際に触れてみると、技術的な難しさよりも運用設計の甘さでつまずく例が多い。代表的な三つを挙げる。
「つなげば賢くなる」と期待してしまう
接続しただけでは、AIは何をすべきか分からない。どの業務の、どの判断を任せるのかを先に決め、それに必要な最小限のツールだけを用意する。目的が曖昧なまま接続先を増やすと、使われないツールばかりが積み上がる。
説明文の粒度が合っていない
ツールの説明が抽象的すぎると、モデルは似た機能のどれを使えばよいか判断できない。逆に内部実装の詳細まで書き込むと、文脈を圧迫する。「何ができて、いつ使うのか」を短く書くのが基本で、実際の呼び出しログを見ながら調整していくとよい。
失敗したときの振る舞いを決めていない
ツールが失敗したとき、どう振る舞うかを決めていないと、AIは同じ呼び出しを繰り返したり、勝手に別の手段を試したりする。エラーの内容を分かる形で返す、再試行の回数を制限する、人に引き継ぐ条件を決めるといった設計が、安定運用には欠かせない。
セキュリティ:便利さの裏側にあるリスク
MCPは外部システムへの入口を増やす技術である。利点と同じだけ、設計を誤ったときの影響も大きい。
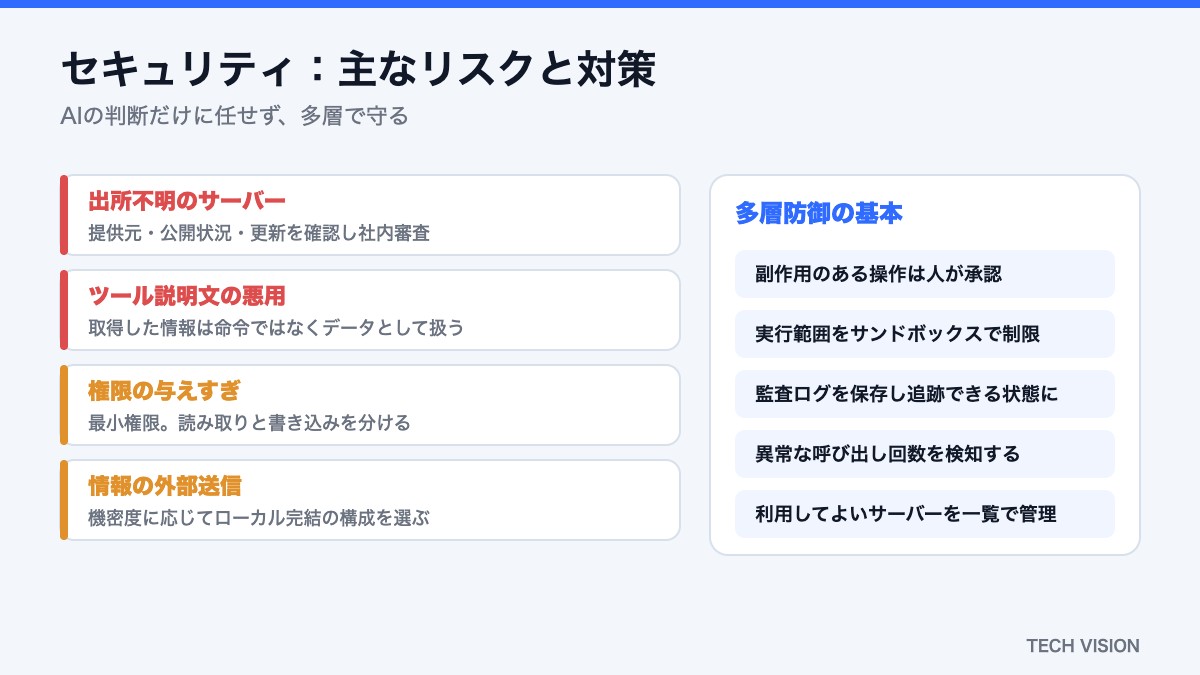
出所の不確かなサーバー
MCPサーバーは、手元や社内のネットワークでコードを実行するプログラムである。公開されているからといって安全とは限らない。提供元、ソースコードの公開状況、更新の継続性を確認し、業務で使うものは社内で審査する体制が望ましい。
ツールの説明文を悪用する攻撃
モデルはツールの説明文を読んで判断するため、説明文に不正な指示を仕込む攻撃が知られている。また、読み込んだファイルやWebページの中に指示文を紛れ込ませるプロンプトインジェクションにも注意が必要だ。「取得した情報は命令ではなくデータとして扱う」という前提を、運用ルールとして明文化しておきたい。
権限の与えすぎ
もっとも起きやすい失敗が、権限の過剰付与である。管理者権限の鍵をそのまま渡す、全ディレクトリへの書き込みを許す、削除系の操作を無条件に許可する――いずれも事故のもとだ。最小権限を原則とし、読み取りと書き込みを分け、対象範囲を明示的に限定する。
情報の外部送信
リモート接続では、社内データが外部のサービスを経由する可能性がある。どのデータがどこへ送られるかを把握し、機密度の高い情報はローカル完結の構成にするなど、置き場所の設計が必要になる。
多層で守る
安全をAIの判断だけに委ねないことが肝心である。副作用のある操作には人の承認を挟む、実行できる範囲をサンドボックスで制限する、監査ログを保存する、異常な呼び出し回数を検知する――こうした多層の対策を組み合わせる。
企業がMCPを導入するときの進め方
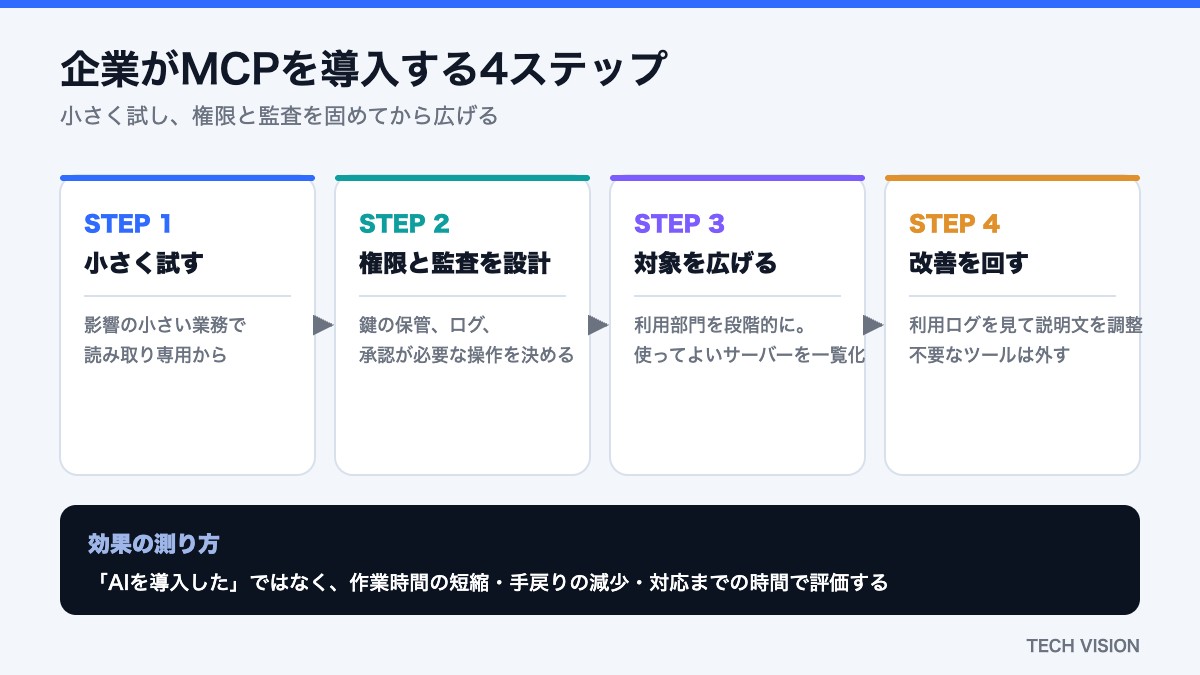
技術的には数時間で試せる一方、組織で使うには準備が要る。次の順序が現実的である。
ステップ1:小さく試す
影響範囲の小さい業務を一つ選び、読み取り専用のサーバーから始める。社内ドキュメントの検索や、課題管理の参照あたりが候補になる。ここでの目的は効果測定ではなく、運用イメージと危険箇所の把握である。
ステップ2:権限と監査を設計する
本格展開の前に、アカウントと権限の設計、鍵の保管方法、ログの保存先と保存期間、承認が必要な操作の線引きを決める。情報システム部門やセキュリティ担当と、この段階で合意しておく。
ステップ3:対象を広げる
運用ルールが固まったら、利用部門を段階的に広げる。あわせて、社内で使ってよいサーバーの一覧を整備すると、各自が野良のサーバーを追加する状況を避けられる。
ステップ4:改善を回す
利用ログを見ると、よく使われるツールと、まったく使われないツールがはっきり分かれる。説明文の書き方を直す、ツールを分割する、不要なものを外すといった手入れを続けることで、精度と安全性が上がっていく。
導入コストと運用の負荷
MCPそのものはオープンな仕様で、利用にライセンス費用はかからない。ただし実運用では、サーバーの開発と保守、権限管理、ログの保管、利用者への教育といった費用が発生する。加えて、ツールの一覧や取得したデータは文脈として渡されるため、接続先が増えるほどAIの利用料金も増える傾向がある。小さく始めて、効果が確認できた領域から広げるのが結果的に安く済む。
効果をどう測るか
「AIを導入した」ではなく、作業時間の短縮、手戻りの減少、対応までの時間といった業務指標で見る。MCPは目的ではなく、既存の仕事を速く正確にするための配管である。
MCPの課題と、これからの論点
クライアントごとの対応差
仕様が共通でも、実装の進み具合はクライアントによって異なる。ある環境で動いたサーバーが、別の環境では一部機能を使えないこともある。導入前に、使う予定の組み合わせで動作を確認しておきたい。
ツールが増えすぎる問題
接続するサーバーを増やすほど、モデルに提示される選択肢が増え、判断の精度が落ちたり、処理に使う文脈が膨らんだりする。用途ごとに接続先を絞る、役割別のプロファイルを用意するといった工夫が要る。
認証と企業運用の作り込み
リモート接続における認可の扱いは、仕様と実装の両面で整備が進んでいる分野である。企業での本格利用には、既存のID基盤との連携、監査要件への対応、障害時の切り分けなど、現場での作り込みがまだ必要になる。
標準としての持続性
MCPは、特定ベンダーの製品ではなくオープンな仕様として運営されている。今後も複数の実装者が関わりながら更新されていく見込みで、仕様の版を追い続ける体制を持てるかどうかが、長期的な運用の分かれ目になる。
よくある質問
Q. MCPと関数呼び出し(Function Calling)は何が違いますか?
A. 関数呼び出しは、モデルが構造化された引数を返す仕組みそのものを指します。MCPは、その呼び出し先となるツールやデータをどのように公開し、接続するかを定めた標準です。対立する概念ではなく、組み合わせて使われます。
Q. MCPを使うには特定のAIモデルが必要ですか?
A. プロトコル自体はモデルに依存しません。実際に使えるかどうかは、利用するアプリ(ホスト)がMCPに対応しているかで決まります。
Q. 開発者でなくても使えますか?
A. 対応アプリに設定を追加するだけで使える構成も増えています。ただし、接続先の選定や権限の設定には技術的な判断が必要なため、業務利用では情報システム部門と一緒に進めるのが安全です。
Q. 社内データが学習に使われることはありませんか?
A. それはMCPではなく、利用しているAIサービスの契約と設定で決まります。業務利用の前に、提供元のデータ取り扱い方針を確認してください。
Q. 個人で試すには何から始めればよいですか?
A. MCPに対応したアプリを用意し、ファイル操作など影響の小さい公式サーバーを一つ接続してみるのが分かりやすい入口です。慣れてきたら、自分の業務に近いサーバーを試すとよいでしょう。
Q. 接続するサーバーはいくつまで増やせますか?
A. 技術的な上限より先に、選択肢が増えることによる精度低下と文脈量の増加が問題になります。日常的に使うものを数個に絞り、用途別に設定を分ける運用が扱いやすいでしょう。
Q. 社内システムに対応サーバーがない場合はどうすればよいですか?
A. 既存のAPIがあれば、その前段に小さなMCPサーバーを用意するのが一般的です。APIがない場合は、先に参照用のAPIを整えるところから始めることになります。
まとめ:MCPは「AIを仕事に接続する」ための配管
MCPは、派手な機能ではない。しかし、AIを試用から日常業務へ移すうえで欠かせない、地味で重要な土台である。
- AIアプリと外部データ・ツールをつなぐオープンな標準プロトコルである
- ホスト・クライアント・サーバーの三層で、JSON-RPCによりやり取りする
- ツール、リソース、プロンプトという形で機能を提供する
- 個別実装の組み合わせ爆発を抑え、乗り換えの自由度を高める
- 権限設計、承認、監査ログを含めた多層防御が前提になる
重要なのは、「何につなぐか」よりも「何につながないか」を決めることだ。接続先を絞り、権限を最小限にし、記録を残す。その設計ができている組織ほど、AIを安心して業務に組み込める。
まずは読み取り専用のサーバーを一つ、影響の小さい業務で試してみてほしい。AIが「知らない」と答えていた領域が、どこまで実用になるのかが具体的に見えてくるはずだ。
※本記事の情報は2026年9月時点のものです。仕様の版、各ツールの対応状況、提供条件は変更される場合があります。実装や導入の前に、公式ドキュメントおよび各サービスの最新情報をご確認ください。