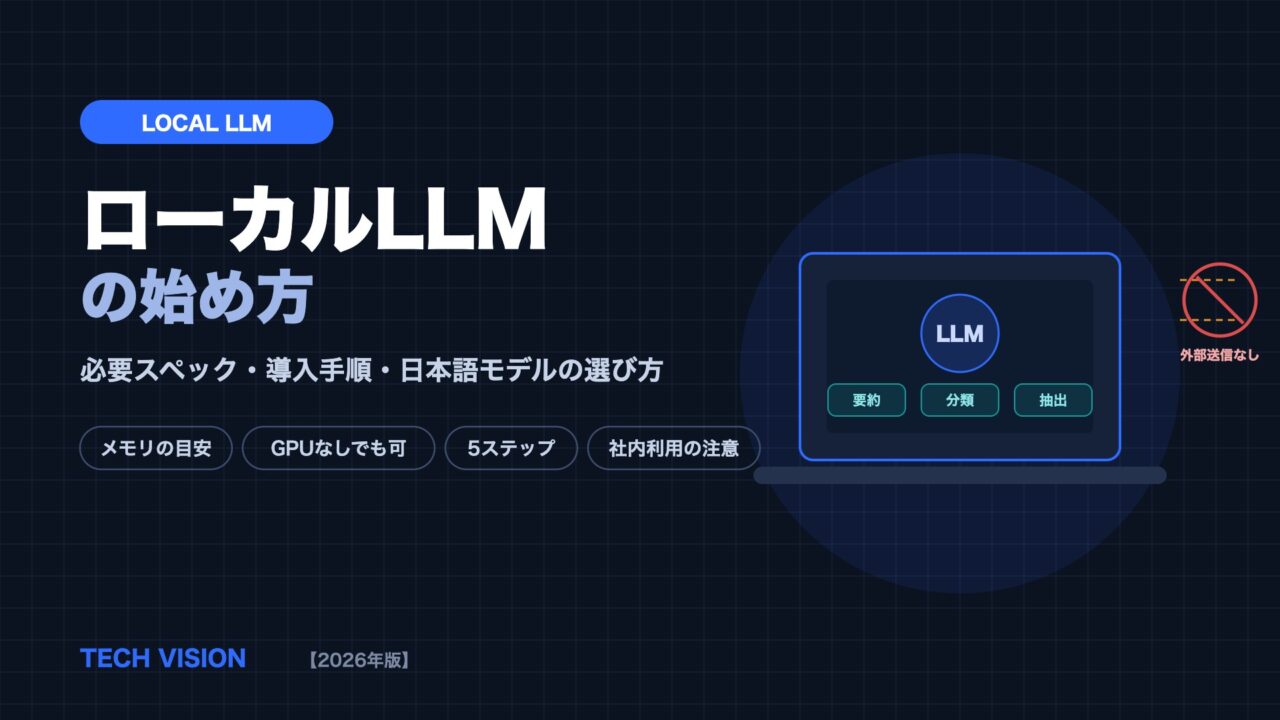
「社内のデータを外に出せないから、生成AIを業務で使えない」。そんな相談を受けることが増えた。答えの一つがローカルLLM――手元のPCや社内のサーバーで動かす言語モデルである。通信も課金も発生せず、入力した内容がどこにも送られない。
数年前までは、専門の機材と知識がなければ手を出せない領域だった。しかし今は、アプリを入れてモデルを選ぶだけで動く環境が整い、一般的なノートPCでも実用的な速度が出るようになっている。
とはいえ、始める前に知っておきたい現実もある。必要なメモリの目安、クラウドの最新モデルとの品質差、日本語の扱い、商用利用の条件、そして社内で使うときのルール。ここを飛ばすと「動いたけれど使えない」で終わってしまう。
本稿では、ローカルLLMの始め方を、必要スペックの目安、三つの導入方法、手順、モデルの選び方、速度を上げる工夫、業務利用の注意点、つまずいたときの対処まで、順を追って解説する。2026年9月時点の情報をもとにしており、ツールやモデルの状況は変化が速いため、導入時は公式の最新情報もあわせて確認してほしい。
この記事の要点
- ローカルLLMとは、自分のPCや社内サーバーで動かす言語モデルのこと
- 最大の利点は、データが外部に出ないこと、通信不要で使えること、従量課金がないこと
- 必要なメモリの目安は、量子化した7〜8B規模でおよそ6GB前後、14B規模でおよそ10GB前後
- 始め方は「デスクトップアプリ」「コマンドライン」「開発ライブラリ」の三つ
- モデルは、日本語の品質、ライセンス、量子化形式、更新の継続性で選ぶ
- 速度は、量子化の強さ、文脈の長さ、GPUへの割り当てで大きく変わる
- 業務利用では、扱ってよいデータの範囲と、出力を人が確認する工程を先に決める
ローカルLLMとは?クラウドAIとの違い
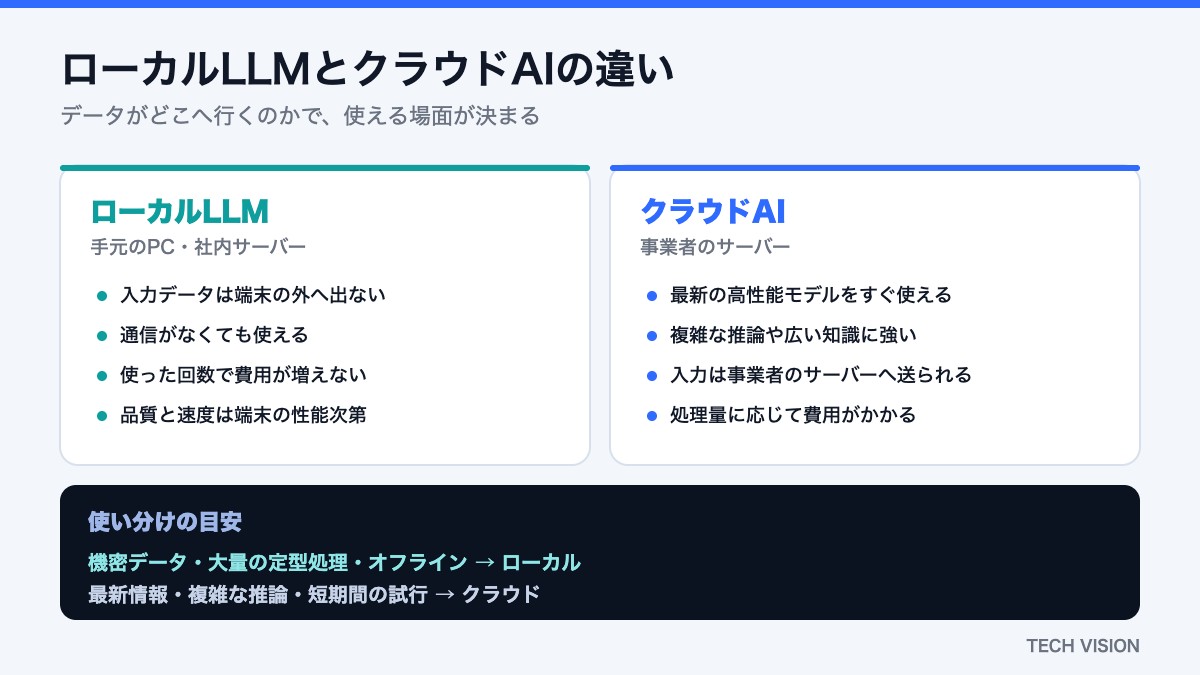
ローカルLLMとは、外部のサービスに接続せず、自分の端末や自社の環境で動かす言語モデルを指す。モデルのファイル(重み)を手元に保存し、その端末の計算資源だけで推論する。
クラウドAIとの違い
クラウドのAIサービスは、入力を事業者のサーバーへ送り、結果を受け取る仕組みだ。最新の高性能モデルをすぐ使える反面、通信が必要で、利用量に応じた費用がかかり、データの取り扱いは契約と設定に依存する。
ローカルLLMはその逆で、手元で完結する代わりに、端末の性能が品質と速度の上限を決める。どちらが優れているかではなく、要件によって使い分けるものだと考えたい。
ローカルLLMが向いている場面
- 社外に出せないデータを扱う(顧客情報、社内文書、開発中の仕様)
- 通信が不安定、または使えない環境で作業する
- 同じ処理を大量に繰り返し、従量課金を避けたい
- 試行錯誤を回数を気にせず行いたい
向いていない場面
- 最新の一般知識や、複雑で長い推論が必要な作業
- 大量の同時アクセスをさばく必要がある業務システム
- 端末のメモリや電力に余裕がない環境
ローカルLLMに必要なスペックの目安
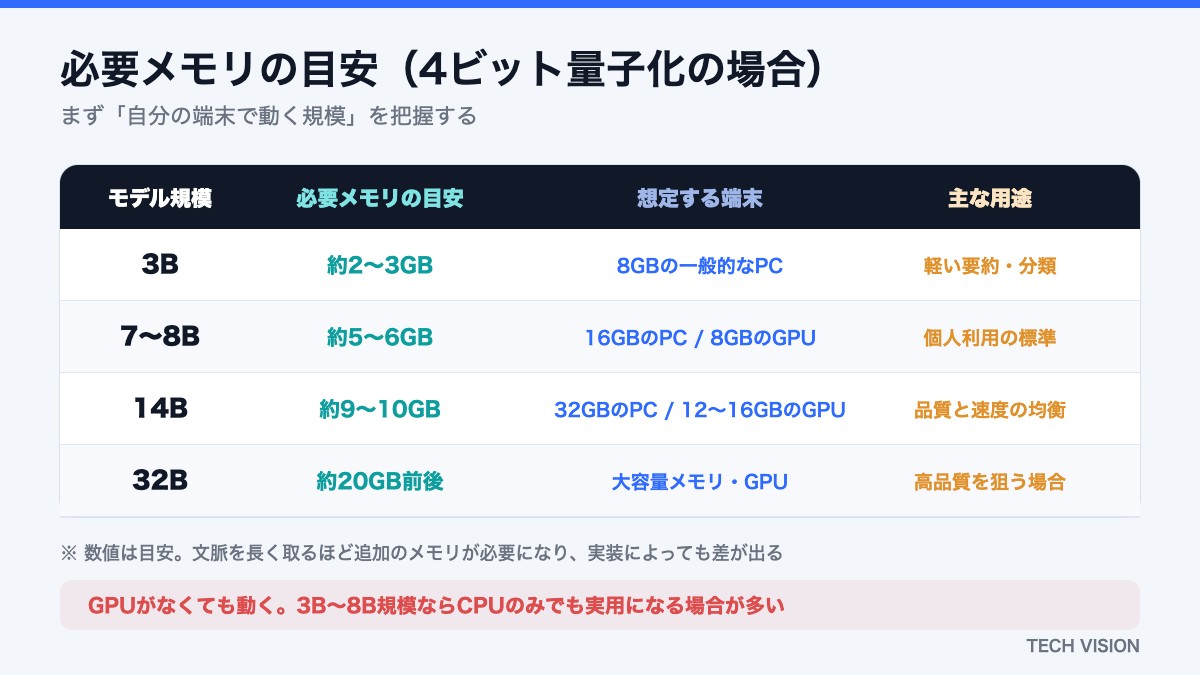
最初の関門が「自分のPCで動くのか」である。判断の軸はメモリ(RAM、またはGPUのVRAM)だ。
モデルの規模と必要メモリの目安
モデルは、4ビット程度に量子化して配布されているものを使うのが一般的である。量子化した状態での、おおよそのメモリ必要量は次のとおり。
- 3B(30億)規模:およそ2〜3GB。軽量な端末でも動きやすい
- 7〜8B規模:およそ5〜6GB。個人利用の標準的な選択肢
- 14B規模:およそ9〜10GB。品質と速度の折り合いが良い
- 32B規模:およそ20GB前後。相応の機材が必要になる
これに加えて、会話の文脈を保持する分のメモリが必要になる。長い文書を渡すほど消費が増えるため、モデルのサイズ+数GBの余裕を見ておくと安心だ。
GPUがなくても動くのか
動く。CPUだけでも推論は可能で、3B〜8B規模であれば実用的な速度が出ることも多い。ただし、GPUがあると生成速度は大きく向上する。長文を頻繁に扱うなら、GPUまたは統合メモリの大きい端末が快適である。
MacとWindows、どちらが有利か
近年のMacは、CPUとGPUがメモリを共有する設計のため、大きなメモリをモデルに割り当てやすいという利点がある。WindowsやLinuxでは、搭載しているGPUのVRAM容量が上限の目安になる。どちらでも動作するので、手持ちの機材のメモリ量から逆算して選べばよい。
ストレージと発熱
モデルのファイルは数GB規模になるため、複数試すなら空き容量に余裕が要る。また、推論中は負荷が高くなり発熱する。ノートPCで長時間動かす場合は、電源と冷却にも注意したい。
OS別の始め方と注意点
基本的な流れはどのOSでも同じだが、つまずく箇所が少し違う。
Macで始める場合
近年のAppleシリコン搭載機は、CPUとGPUが同じメモリを共有するため、搭載メモリの大部分をモデルに割り当てられるのが強みである。16GB機なら7〜8B規模、32GB機なら14B規模あたりが快適な目安になる。アプリ形式の実行環境が充実しており、導入の手間も少ない。注意点は、大きなモデルを動かすと他のアプリに回るメモリが減ること、そしてバッテリー駆動では発熱と消費が大きいことだ。
Windowsで始める場合
判断の基準はGPUのVRAM容量である。8GBなら7〜8B規模、12〜16GBなら14B規模が目安になる。VRAMに収まらない分は本体のメモリとCPUで処理されるため、速度は落ちるが動作はする。導入時は、GPUのドライバを最新にしておくこと、実行環境がGPUを認識しているかを確認することが要点になる。
Linuxで始める場合
サーバーに置いて社内で共有する用途では、Linuxが選ばれることが多い。コマンドライン中心で扱え、API形式で提供しやすい。複数人で使う場合は、同時実行数とメモリの上限を先に決めておくと、応答が極端に遅くなる事態を避けられる。
共通して確認したいこと
いずれのOSでも、ストレージの空き容量、電源と冷却、そして実行環境の配布元が公式かどうかは必ず確認したい。モデルのファイルは一つで数GBあるため、試すうちに容量を圧迫しやすい点にも注意する。
クラウドAIとの使い分け早見表
どちらか一方に寄せる必要はない。作業の性質で振り分けるのが、もっとも無理がない。
- 顧客情報や社内文書を扱う:ローカル。外部送信が発生しない構成にする
- 最新のニュースや一般知識を調べる:クラウド。学習時点以降の情報に強い
- 同じ処理を毎日大量に回す:ローカル。件数が増えても費用が跳ね上がらない
- 複雑な企画や長い文章を練る:クラウド。推論の深さで差が出る
- 通信が不安定な現場で使う:ローカル。オフラインでも止まらない
- 短期間で試して評価したい:クラウド。準備の手間が少ない
実務では、下ごしらえをローカルで行い、仕上げだけクラウドに任せるといった併用も有効である。機密部分を伏せてから渡す運用にすれば、両方の利点を取りやすい。
ローカルLLMの始め方:三つの方法
導入方法は大きく三種類ある。目的と技術的な慣れで選べばよい。
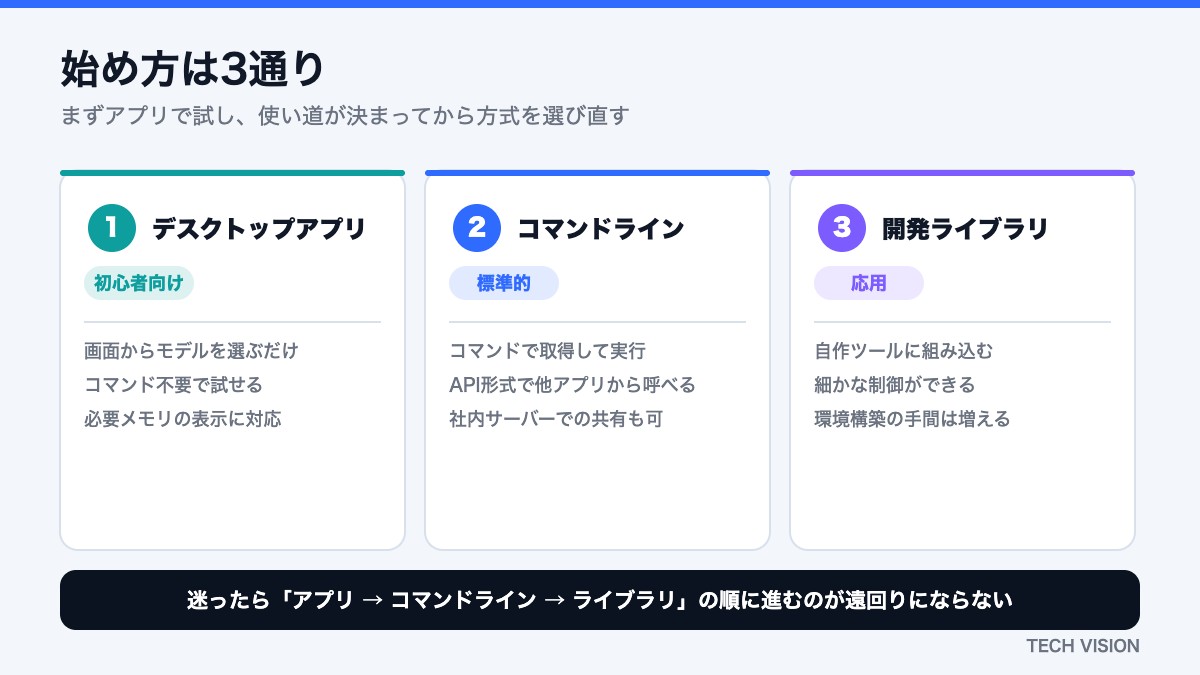
方法1:デスクトップアプリを使う(初心者向け)
チャット画面が用意されたアプリを入れ、一覧からモデルを選んでダウンロードするだけで使える。設定ファイルもコマンドも不要で、まず体験したい人に適している。モデルの切り替えや、必要メモリの表示に対応しているものが多い。
方法2:コマンドラインツールを使う(標準的)
端末からコマンドでモデルを取得し、実行する方式である。少し慣れが必要だが、APIのような形で他のアプリから呼び出せるものが多く、自動化や開発との相性が良い。社内サーバーに置いて共有する使い方もできる。
方法3:開発ライブラリを組み込む(応用)
自作のツールや業務システムに組み込む場合は、推論ライブラリを直接使う。細かな制御ができる反面、環境構築の手間は増える。すでに動くものを作る目的が明確な場合に選びたい。
どれを選ぶか
迷ったら、まずアプリで試し、使い道が定まってからコマンドライン方式へ移るのが遠回りにならない。最初から開発ライブラリを触るのは、目的がはっきりしている場合に限ったほうがよい。
導入の手順(5ステップ)
ここでは、もっとも一般的なアプリまたはコマンドライン方式を想定した流れを示す。
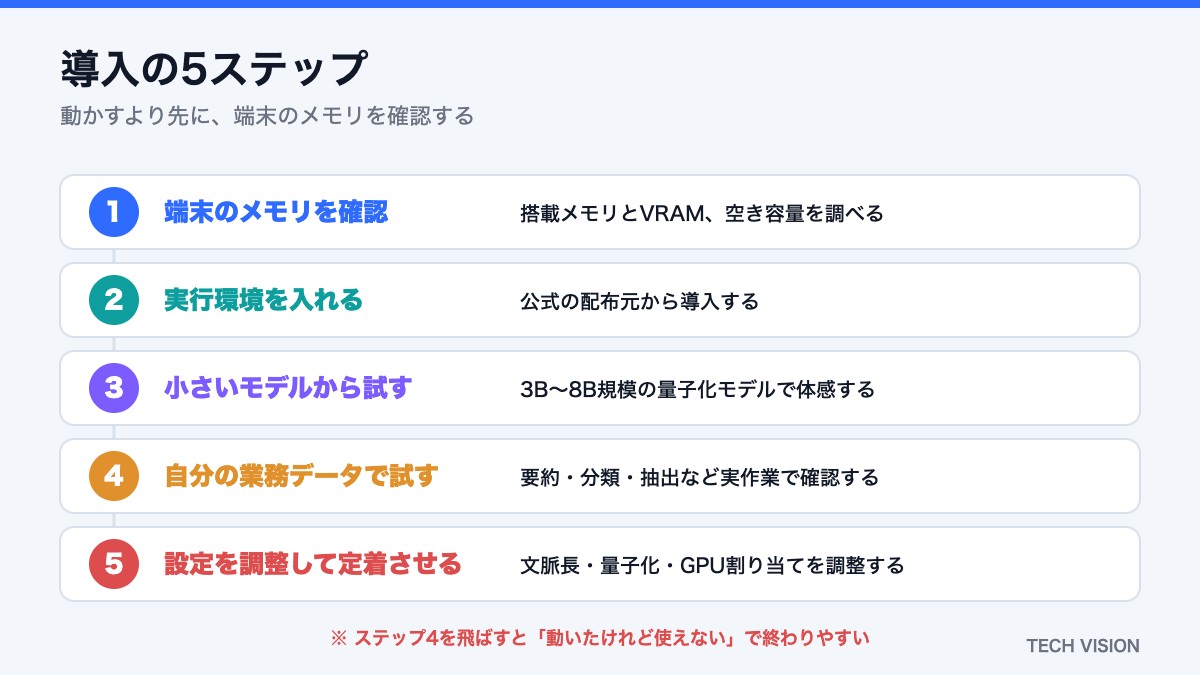
ステップ1:端末のメモリを確認する
搭載メモリ(とGPUのVRAM)を調べ、動かせるモデル規模の見当をつける。空き容量も確認しておく。ここを飛ばすと、動かないモデルを延々とダウンロードすることになる。
ステップ2:実行環境を入れる
選んだアプリ、またはコマンドラインツールを公式サイトから導入する。配布元が公式かどうかを必ず確認する。非公式の再配布版は、安全性の面で避けたい。
ステップ3:小さいモデルから試す
いきなり大きなモデルを選ばず、3B〜8B規模の量子化モデルから始める。実際の生成速度と、日本語の自然さを体感することが目的である。
ステップ4:自分の業務データで試す
一般的な質問ではなく、実際に任せたい作業で試す。議事録の要約、問い合わせの分類、書類からの項目抽出など。ここで実用になるかどうかが判断できる。
ステップ5:設定を調整して定着させる
文脈の長さ、量子化の強さ、GPUへの割り当てなどを調整し、速度と品質の折り合いを取る。よく使う指示は定型文として保存しておくと、日常的に使えるようになる。
モデルの選び方:見るべき4つの基準
ローカルで動かせるモデルは数多く公開されている。迷わないための基準を挙げる。
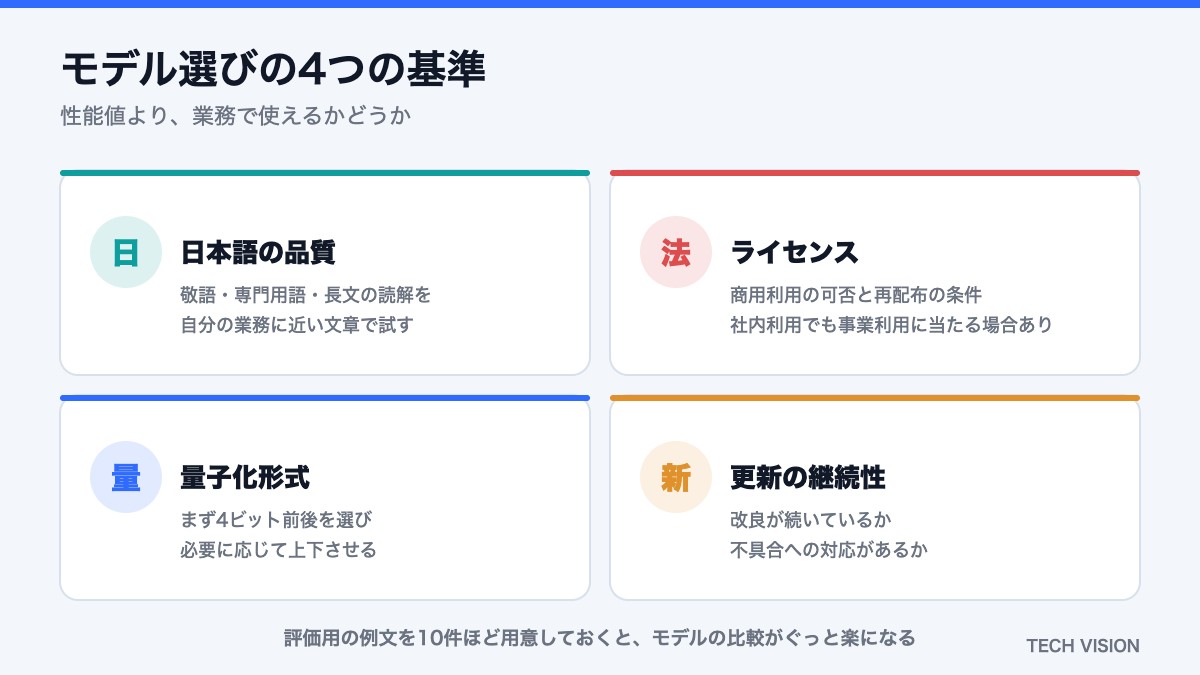
1. 日本語の品質
多言語対応をうたっていても、日本語の自然さには差がある。敬語、専門用語、長い文の読解を、自分の業務に近い文章で試すのが確実だ。日本語データを重視して学習されたモデルも公開されている。
2. ライセンスと商用利用
公開モデルにも利用条件がある。商用利用の可否、再配布の扱い、出力の権利関係は、業務で使う前に必ず確認する。社内利用であっても、事業に使うなら商用利用にあたる場合が多い。
3. 量子化形式と配布状況
同じモデルでも、量子化の強さによって複数の版が配布されている。強く量子化するほど軽く速くなるが、品質は落ちる。まず中程度(4ビット前後)を選び、必要に応じて上下させるのが定石である。
4. 更新の継続性
提供元が改良を続けているか、不具合への対応があるか。更新が止まったモデルに業務を載せると、後から動かしにくくなる。
速度と品質を調整する「つまみ」
ローカルLLMは、設定次第で体感が大きく変わる。触るべき項目は限られている。
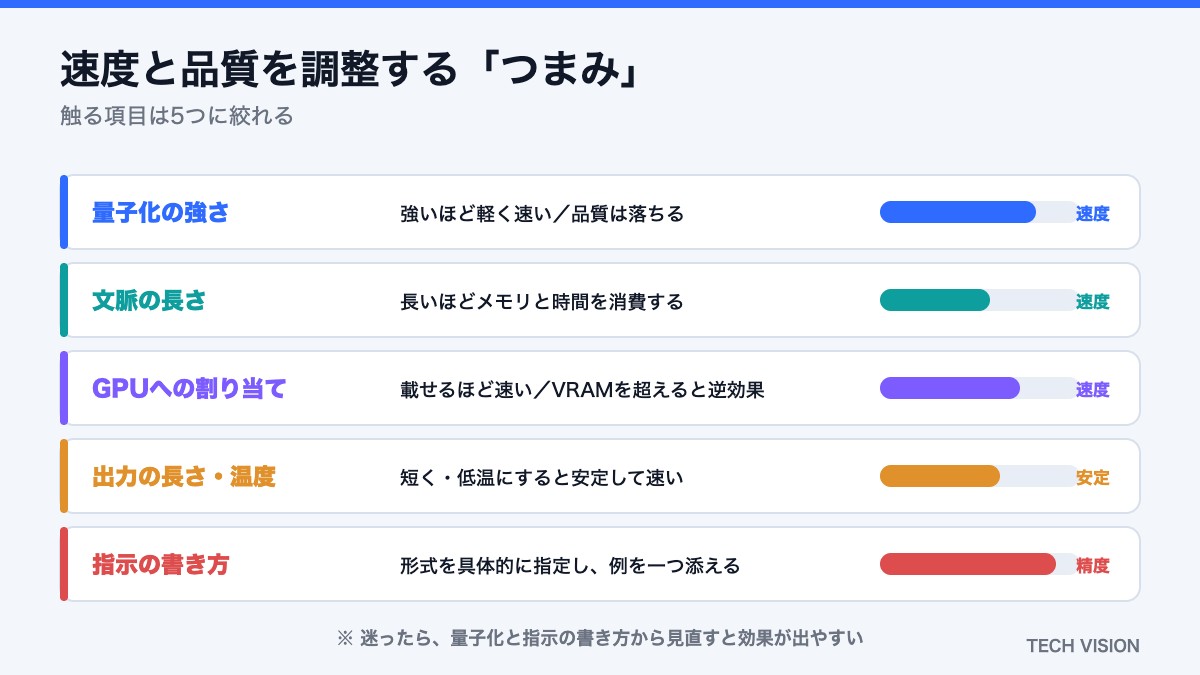
量子化の強さ
もっとも効果が大きい。軽くしたいなら強めに、品質を優先するなら控えめに。同じ作業で比較して決めるのが確実である。
文脈の長さ(コンテキスト)
扱える文字数を増やすほど、メモリ消費と処理時間が増える。長文を渡す予定がないなら、必要最小限に設定するほうが快適だ。
GPUへの割り当て
モデルの一部または全部をGPUに載せると、生成速度が上がる。VRAMに収まらない場合は、載せる割合を調整する。収まりきらない状態で無理に動かすと、かえって遅くなる。
出力の長さと温度
生成する長さを絞れば、待ち時間は短くなる。創造性を左右する設定(温度)は、分類や抽出のような作業では低めにすると安定する。
指示の書き方
軽量なモデルほど、曖昧な指示に弱い。出力形式を具体的に指定し、例を一つ添えるだけで、精度は目に見えて上がる。
ローカルLLMの使いどころ
実際にどんな作業に向くのか、現実的な例を挙げる。
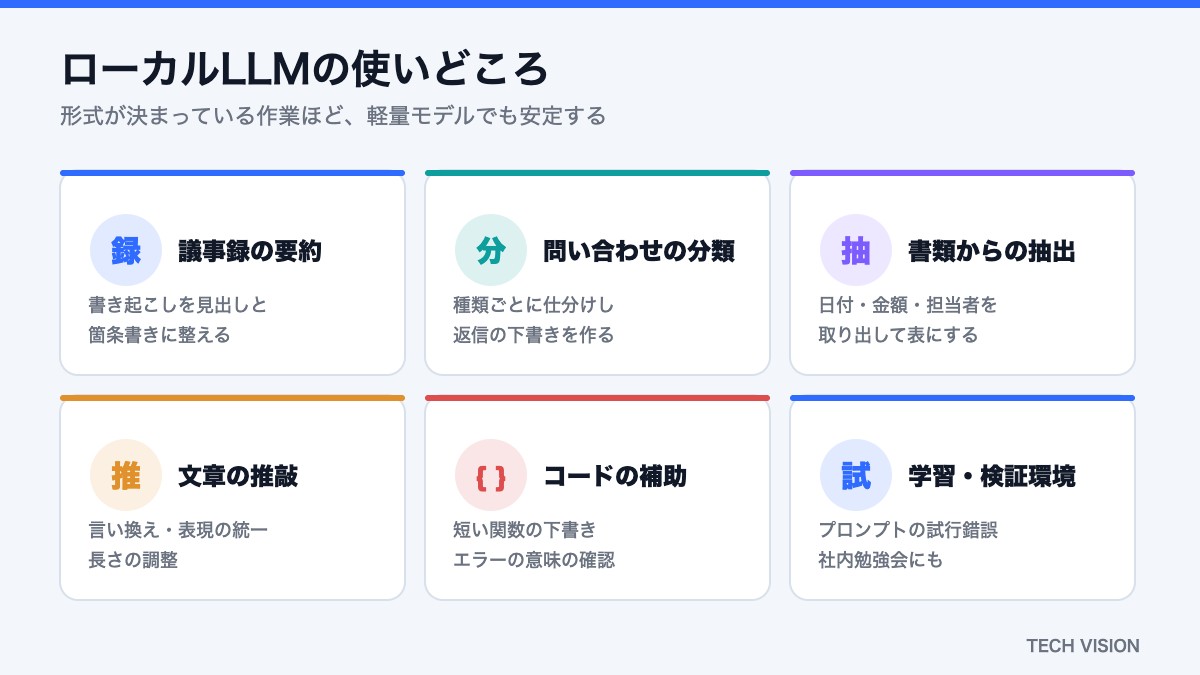
議事録・メモの要約と整形
録音から起こした文字列を、見出しと箇条書きに整える。社内の会議内容を外部に送らずに処理できる点が大きい。
一方、社外秘ではない会議や、データの取り扱い条件を確認したうえで使える場面なら、録音から文字起こし・要約までを1台でこなすAI議事録デバイスに任せるのも手だ。記録づくりの手間が減り、整理や活用に時間を回せる。

PR:Plaud(AI議事録デバイス)
問い合わせの分類と下書き
内容を種類ごとに仕分けし、定型的な返信の下書きを作る。判断が難しいものだけ人が対応すれば、処理時間を圧縮できる。
書類からの項目抽出
見積書や報告書から、日付、金額、担当者などを取り出して表にする。形式が決まっている作業ほど、軽量モデルでも安定する。
文章の推敲・言い換え
社外向けの文章を整える、表現を統一する、長さを調整する。手元で何度でも試せるため、気兼ねなく回数を重ねられる。
コードの補助
短い関数の下書き、エラーメッセージの意味の確認、コメントの追加など。機密性の高いコードを扱う現場では、手元で完結する価値が高い。
学習・検証用の環境として
プロンプトの試行錯誤や、社内向けの勉強会にも向く。従量課金を気にせず触れるため、心理的な障壁が下がる。
モデルの規模と用途の考え方についてはSLM(小規模言語モデル)とは?、AIを社内のツールやデータにつなぐ方法についてはMCP(Model Context Protocol)とは?もあわせて参考にしてほしい。
社内文書を検索して答えさせるには
ローカルLLMを業務で使う際、もっとも要望が多いのが「社内の資料をもとに答えてほしい」という使い方である。これはモデルに覚えさせるのではなく、質問のたびに関連する文書を探して渡す仕組みで実現する。
基本の流れ
まず社内文書を細かく分割して検索できる形に変換し、質問が来たら関連しそうな箇所を取り出す。その本文をモデルへ渡し、「この範囲の情報だけを根拠に答えて」と指示する。こうすると、知らないことを想像で答える頻度が下がり、出典も示しやすくなる。
ローカルで完結させる利点
検索の仕組みもモデルも手元に置けば、社内文書が一切外部へ出ない。閲覧権限の設計を検索側で行えば、利用者ごとに見える範囲を制御することもできる。
つまずきやすい点
精度が出ない原因の多くは、モデルではなく検索側にある。文書の分割が粗い、見出し情報が失われている、表が崩れている――こうした前処理の質が結果を左右する。まず検索単体で「正しい箇所が出てくるか」を確認してから、モデルに渡す工程へ進むとよい。
費用はどれくらいかかるのか
「無料で使える」と紹介されることが多いが、正確には利用料がかからないだけで、別の形の費用は発生する。
かからない費用
多くの実行環境と公開モデルは無償で入手でき、使用回数による従量課金もない。何度試しても金額が増えないため、試行錯誤の回数を気にしなくてよいのは実務上の大きな利点である。
かかる費用
- 機材:メモリに余裕のあるPC、またはGPU。既存の端末で足りるかがまず分かれ目になる
- 電気代:推論中は消費電力が上がる。常時稼働させるなら無視できない
- 人の時間:導入、評価、指示文の調整、更新作業。実際はここが最大の費用になりやすい
クラウドとの分岐点
処理件数が少なく内容も多様なら、クラウドのAPIのほうが安く済む。反対に、同じ処理を大量に回す、または機密性の要件があるなら、手元で動かす価値が出る。件数の見通しを立て、両方を試して比較するのが確実である。
業務で使うときの注意点
「手元で動くから安全」と単純に考えるのは危うい。組織で使うなら、いくつか決めておくべきことがある。
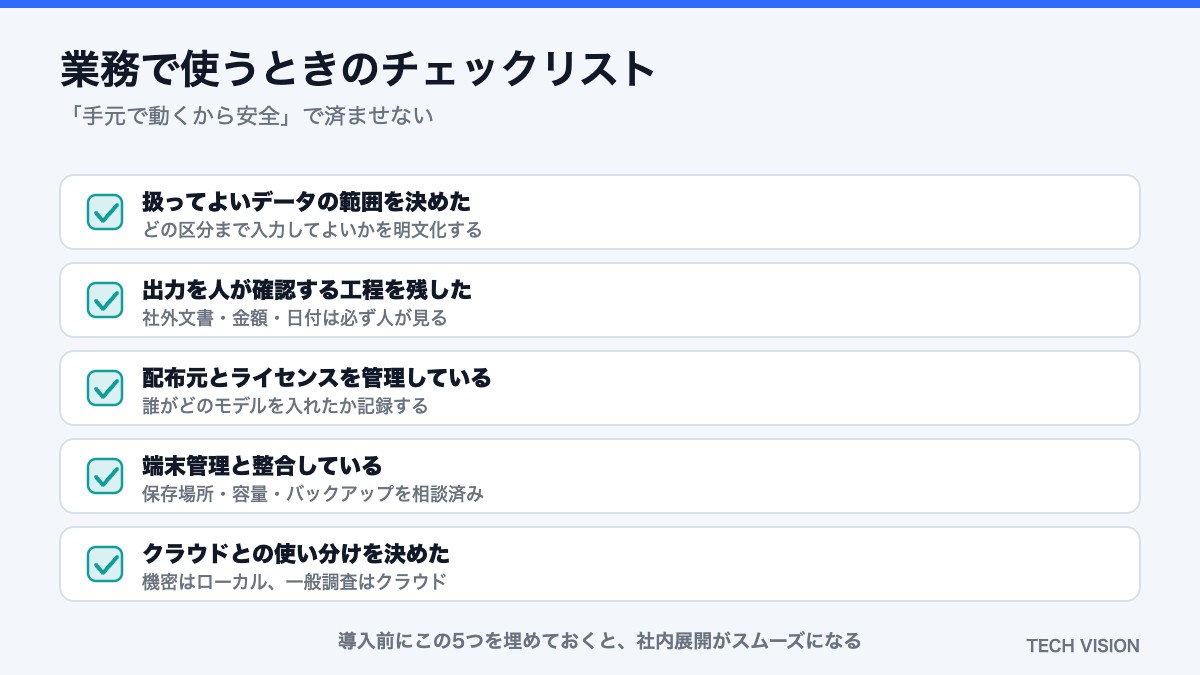
扱ってよいデータの範囲を決める
ローカルで完結するとはいえ、端末の紛失や共有設定の誤りは起こりうる。どの区分のデータまで入力してよいかを明文化し、利用者に共有する。
出力を人が確認する工程を残す
軽量モデルは、自然な文章で誤った内容を返すことがある。社外に出る文書、金額や日付が関わる処理では、人の確認を必ず挟む。
配布元とライセンスを管理する
誰がどのモデルをどこから入れたのか、記録を残す。ライセンスの条件も含めて、社内で使ってよいモデルの一覧を整備しておくと混乱を防げる。
端末管理との整合
モデルのファイルは大きく、バックアップや端末の入れ替えに影響する。情報システム部門と、保存場所や容量の扱いを事前に相談しておきたい。
クラウドとの併用ルール
機密データはローカル、一般的な調べものはクラウドと、使い分けの基準を決めておくと、利用者が迷わない。
ローカルLLMによくある誤解
「クラウドの最新モデルと同じことができる」
できない部分がある。広い一般知識や、条件が複雑に絡む推論は、依然としてクラウドの大規模モデルに分がある。定型作業に絞れば実用になる、という理解が正確だ。
「高価なGPUが必須」
必須ではない。規模を選べば一般的なノートPCでも動く。まず小さいモデルで試し、必要性が確認できてから機材を検討する順序が無駄がない。
「一度入れたら終わり」
モデルもツールも更新が速い。定期的に評価し直し、差し替えられる状態にしておくことが、長く使うための条件になる。
「手元だから何を入力しても安全」
外部送信がない点は確かだが、端末そのものの管理は別問題である。共有端末での利用や、履歴の保存場所にも目を配りたい。
導入前に確認したい5つの質問
着手する前に、次の問いに答えられるかを確かめておくと遠回りを避けられる。
- 任せたい作業は何か:「なんとなく便利そう」ではなく、一つの具体的な作業に絞れているか
- どこまでの品質が必要か:人の確認を挟む前提か、完全自動を目指すのか
- 手元の機材で足りるか:メモリの目安から、動かせる規模を把握しているか
- 誰が評価するか:業務を知る人が、良し悪しを判断できる体制になっているか
- ルールは決まっているか:入力してよいデータの範囲を明文化できているか
五つすべてに即答できなくても構わないが、一つ目と三つ目が曖昧なまま始めると、ほぼ確実に迷走する。まずは小さな作業を一つ選び、動かしながら残りを埋めていくのが現実的である。
うまくいかないときのチェックリスト
動かない・すぐ落ちる
メモリ不足がほとんどの原因である。より小さいモデルか、強めに量子化した版を試す。文脈の長さの設定を下げるのも効く。
生成が極端に遅い
モデルがGPUに載りきっていない可能性がある。割り当ての設定を見直すか、規模を一段下げる。バックグラウンドで動いている他のアプリも確認したい。
日本語が不自然
モデルの相性の問題であることが多い。日本語を重視したモデルに変える、量子化を控えめにする、指示文を具体的にする――この順で試すとよい。
指示を無視する・形式が崩れる
出力形式を明示し、例を添える。それでも崩れるなら、一度に頼む作業を分割する。軽量モデルは、単純な指示を積み重ねるほうが安定する。
同じ質問で答えが変わる
設定上の乱数の影響である。安定させたい作業では、温度を下げる、または固定の設定を用いる。
よくある質問
Q. ローカルLLMは無料で使えますか?
A. 多くの実行環境と公開モデルは無償で利用できます。ただし商用利用の可否はモデルごとに異なるため、ライセンスの確認が必要です。電気代と機材費はかかります。
Q. GPUがないノートPCでも動きますか?
A. 動きます。3B〜8B規模の量子化モデルなら、CPUのみでも実用になる場合が多いです。長文を扱うと待ち時間は長くなります。
Q. メモリは何GBあれば十分ですか?
A. 目安として、8GBで3B規模、16GBで7〜8B規模、32GBで14B規模が快適に動く水準です。文脈を長く取る場合はさらに余裕が要ります。
Q. クラウドの最新モデルと比べて品質はどうですか?
A. 一般知識や複雑な推論では差があります。一方、分類、抽出、要約、整形といった定型作業では、実務に十分な品質が出ることが多いです。
Q. 社内の機密データを入力しても大丈夫ですか?
A. 通信を伴わない構成であれば外部送信は発生しません。ただし端末管理や利用ルールは別途必要です。導入前に情報システム部門と取り扱い範囲を決めてください。
Q. 学習(ファインチューニング)は必要ですか?
A. 多くの場合は不要です。指示文の工夫と、参照させる文書の渡し方で十分な精度になることが多く、まず調整なしで試すことをおすすめします。
Q. 社内文書を検索して答えさせることはできますか?
A. できます。文書を検索して関連部分をモデルに渡す仕組みを組み合わせる方法が一般的で、モデル自体に知識を覚えさせるより更新が容易です。
Q. 複数人で共有できますか?
A. 社内サーバーに置き、API経由で利用する構成が使われます。同時利用が増えるほど処理が重くなるため、規模と台数の設計が必要です。
Q. モデルの更新はどうすればよいですか?
A. 新しい版が出たら、同じ評価用の入力で比較し、良ければ差し替えます。いつでも前の版に戻せるようにしておくと安全です。
Q. 日本語に強いモデルはどう探せばよいですか?
A. 公開されているモデルの説明で、日本語データの比率や対応状況を確認し、自社の文章で実際に試すのが確実です。評価用の例文を10件ほど用意しておくと比較しやすくなります。
Q. ローカルLLMの導入にどれくらい時間がかかりますか?
A. アプリ形式なら、導入からモデルのダウンロードまで30分ほどで最初の応答を得られることが多いです。業務で使える水準に調整するには、評価と試行を含めて数日から数週間を見ておくと現実的です。
Q. 画像や音声も扱えますか?
A. 画像を扱えるモデルも公開されており、手元で動かせます。ただし必要なメモリは増えるため、テキスト専用のモデルより条件は厳しくなります。用途が明確なら試す価値があります。
まとめ:まず小さく動かし、使い道を見つける
ローカルLLMは、特別な機材がなくても始められる段階に入った。重要なのは、最初から完璧を目指さないことだ。
- メモリの目安から、動かせる規模を先に把握する
- まずアプリで試し、使い道が定まってから方式を選び直す
- モデルは日本語品質・ライセンス・量子化形式・更新状況で選ぶ
- 速度は量子化・文脈長・GPU割り当てで調整する
- 業務利用では、データ範囲と人の確認工程を先に決める
クラウドのAIを置き換えるものではなく、持ち出せないデータや、回数を気にしたくない作業を引き受ける選択肢と捉えるのが実践的である。まずは手元のPCで小さなモデルを一つ動かし、自分の仕事のどこに嵌まるかを確かめてみてほしい。
※本記事の情報は2026年9月時点のものです。必要スペックの数値は目安であり、実行環境やモデルの実装によって変わります。ライセンス条件やツールの仕様は変更される場合があるため、導入の前に各提供元の公式情報をご確認ください。